
Im vorigen Kapitel ging es um plausible falsche Aussagen. Ein LLM kann eine überzeugende Antwort schreiben, obwohl ihm eine verlässliche Grundlage fehlt. Eine Anwendung kann deshalb zuerst passende Quellen suchen und dem Modell die gefundenen Textstellen mitgeben. [1]
Eine Frage an ein Bibliotheksarchiv
Stellen wir uns ein Bibliotheksarchiv vor, in dem historische Zeitungsartikel gespeichert sind. Jemand möchte wissen, wann die örtliche Stadtbibliothek eröffnet wurde. Die Anwendung sucht passende Artikel im Archiv und gibt dem LLM die gefundenen Textstellen zusammen mit der Frage. Das Modell soll daraus eine Antwort formulieren, die sich auf diese Quellen stützt. So kann es Informationen aus dem Archiv verwenden, ohne zuvor mit dessen gesamten Bestand trainiert worden zu sein. Finden sich keine passenden Belege, sollte die Anwendung das kenntlich machen, statt eine unbelegte Antwort auszugeben. [1]
Die Frage und die Zeitungsartikel können unterschiedliche Wörter verwenden. Eine Suche nach dem genauen Wort „Stadtbibliothek“ könnte einen Artikel übersehen, der von der „städtischen Bücherei“ spricht. Gesucht sind deshalb auch Textstellen, die inhaltlich zur Frage passen, ohne dieselben Wörter zu verwenden. Dafür lässt sich Text in eine Zahlenrepräsentation umwandeln, mit der Software Ähnlichkeit berechnen kann. Eine solche Suche nach inhaltlicher Nähe nennt man semantische Suche. [2]
Was ein Embedding ist
Ein Embedding ist eine Darstellung von Daten durch Zahlen, mit der Software Beziehungen zwischen diesen Daten berechnen kann. In unserem Archivbeispiel geht es um den Inhalt von Texten. Dafür verarbeitet ein speziell trainiertes Embeddingmodell eine Frage oder einen Textabschnitt und erzeugt daraus eine geordnete Liste von Zahlen. Das Modell ist darauf trainiert, dass inhaltlich ähnliche Texte auch ähnliche Zahlenmuster erhalten. Eine Frage nach der Eröffnung der „Stadtbibliothek“ und ein Artikel über die Einweihung der „städtischen Bücherei“ können dadurch als zusammengehörig gefunden werden, obwohl sie unterschiedliche Wörter verwenden. Die Suchsoftware vergleicht dafür die Zahlenlisten der Frage und der gespeicherten Textabschnitte. Eine solche Liste nennt man Vektor; jede Position darin entspricht einer Dimension. Die einzelnen Zahlen haben dabei meist keine Bedeutung, die wir unmittelbar ablesen könnten. Erst ihr Zusammenspiel ermöglicht den Vergleich. Das Embedding ersetzt also nicht den Originaltext, sondern dient als berechenbare Darstellung für die Suche. [2]
Welche Beziehungen ein Embeddingmodell gut erfasst, hängt davon ab, wofür es trainiert wurde. Ein Modell für einzelne Wörter eignet sich deshalb nicht automatisch für die Suche in längeren Zeitungsartikeln. Für unser Archiv brauchen wir ein Modell, das Fragen und Textabschnitte so darstellt, dass passende Inhalte über ihre Vektoren gefunden werden können. Ob das mit den vorhandenen Artikeln zuverlässig funktioniert, muss die Anwendung anhand konkreter Suchfragen prüfen. [2]
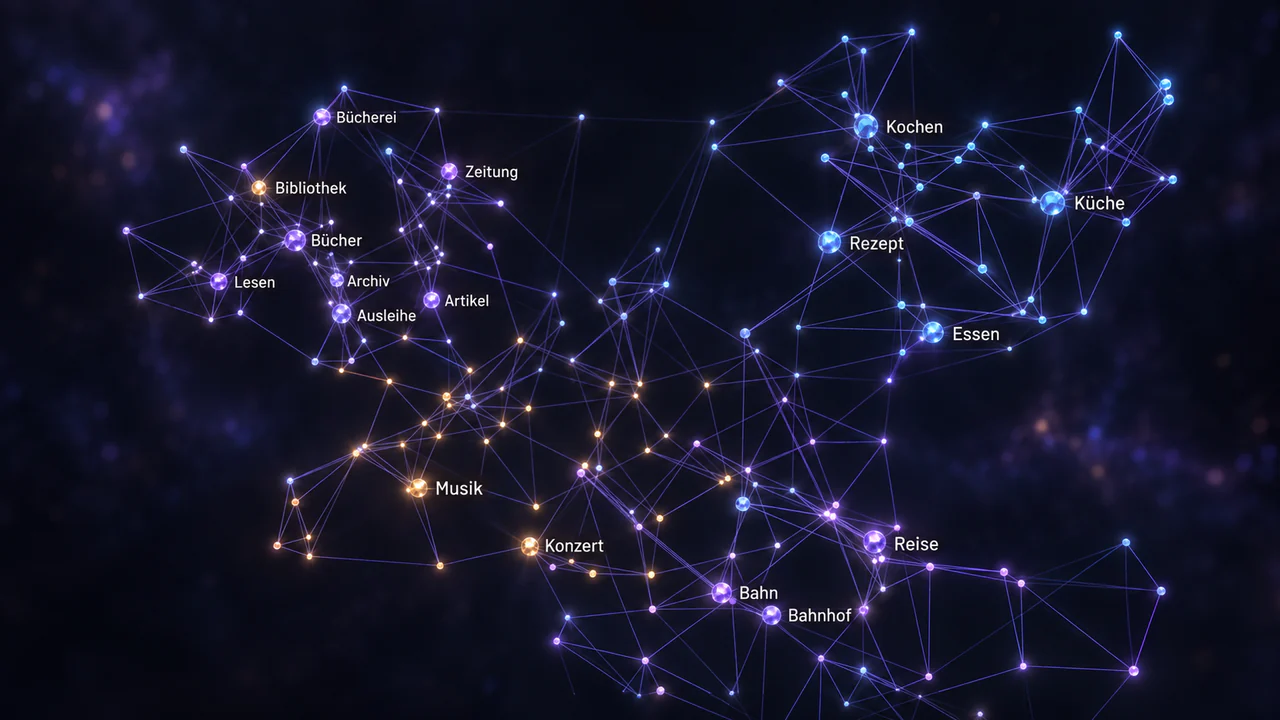
Man kann sich die Embeddings wie Positionen auf einer Galaxiekarte vorstellen. Jeder Textabschnitt ist darin ein Stern. Texte mit ähnlichen Inhalten sollen nahe beieinanderliegen, auch wenn sie unterschiedliche Wörter verwenden. Auch die Frage erhält eine Position auf dieser Karte. Die Suchsoftware sucht dann nach Textabschnitten in ihrer Nähe. Anders als eine räumliche Galaxiekarte hat dieser Zahlenraum allerdings nicht nur drei, sondern häufig Hunderte oder Tausende Dimensionen. Wir können ihn deshalb nicht vollständig darstellen, aber die Software kann die Nähe zwischen den Positionen berechnen. Die Galaxiekarte macht diese Beziehungen anschaulich; sie ist keine tatsächliche Karte des Wissens. [2]
Diese Wortkarte veranschaulicht das Galaxiebild. Ihre Positionen und Verbindungen sind erfunden, keine berechneten Embeddings. Sie durchsucht kein Archiv. Drehe die Karte mit den Schaltflächen oder durch Ziehen mit der Maus. Auf dem Touchscreen drehen zwei Finger die Karte, während ein Finger weiterhin die Seite scrollt. Die Schaltflächen funktionieren auch mit Tab und Enter. Nichts bewegt sich automatisch.
Vollständige Beschreibung der Wortkarte
Die Illustration enthält 214 Punkte, davon 18 beschriftete, und 547 Verbindungen. Zur Bibliotheksgruppe gehören Bibliothek, Bücherei, Bücher, Lesen, Ausleihe, Archiv, Zeitung und Artikel. Eine weitere Gruppe umfasst Kochen, Küche, Rezept und Essen. Die Reisegruppe enthält Bahn, Bus, Reise und Bahnhof, die Musikgruppe Musik und Konzert.
Die Gruppen erstrecken sich in drei Raumrichtungen. Beim Drehen wird die Tiefe sichtbar, die ein flaches Bild verdeckt. Die unbeschrifteten Punkte verdichten die Illustration und stehen nicht für bestimmte Texte. Die Linien verbinden nahe Punkte in dieser erfundenen Anordnung. Weder Abstand noch Farbe oder Verbindung zeigen eine gemessene Ähnlichkeit, einen Quellenverweis oder ein Wahrheitsurteil. Echte Textembeddings haben gewöhnlich weit mehr als drei Dimensionen. Diese Illustration ist keine Projektion solcher Embeddings.
Ähnlichkeit ist kein Wahrheitsurteil. Zwei widersprüchliche Zeitungsartikel können dasselbe Ereignis behandeln und beide zur Frage passen. Ein Artikel kann beispielsweise die geplante Eröffnung der Bibliothek ankündigen, während ein späterer über ihre Verschiebung berichtet. Die Embeddings helfen dabei, passende Textstellen zu finden. Sie prüfen aber nicht, welche Angaben die Frage tatsächlich beantworten oder ob die Quelle verlässlich ist.
Vom Dokument zum Suchtreffer
Für die Suche werden längere Dokumente üblicherweise in kleinere Textabschnitte zerlegt. Diese Aufteilung heißt Chunking. In unserem Archiv könnte beispielsweise ein längerer Zeitungsartikel mehrere Themen behandeln. Würde die Anwendung daraus nur ein einziges Embedding erzeugen, könnte die kurze Meldung zur Bibliothek zwischen den anderen Themen untergehen. Deshalb sollen die Abschnitte möglichst zusammengehörige Inhalte enthalten. Sie dürfen aber auch nicht so klein sein, dass wichtige Zusammenhänge verloren gehen — etwa die Verbindung zwischen einem Eröffnungsdatum und der Bibliothek, auf die es sich bezieht. Wie die Texte sinnvoll aufgeteilt werden, hängt deshalb vom jeweiligen Material ab. [3]
Die Software erzeugt für die einzelnen Textabschnitte Embeddings und bereitet sie für die Suche vor. Dafür verwendet sie einen Suchindex, eine Datenstruktur, mit der sich passende Einträge gezielt finden lassen. Eine Vektordatenbank kann die Vektoren speichern und solche Ähnlichkeitssuchen unterstützen. Dabei muss jeder Vektor mit dem zugehörigen Originaltext verbunden bleiben. Im Bibliotheksarchiv sollte außerdem erkennbar sein, aus welcher Zeitung, Ausgabe und Seite eine Passage stammt. Denn das LLM braucht später die gefundenen Textstellen, nicht deren Zahlenvektoren. Die Fundstellen ermöglichen es anschließend, die Antwort anhand der Originalquellen zu überprüfen. [1]
Wenn jemand eine Frage stellt, erzeugt die Software auch dafür ein Embedding und sucht nach ähnlichen Vektoren im Index. Damit der Vergleich sinnvoll ist, müssen die Frage und die gespeicherten Textabschnitte in einem zueinander passenden Zahlenraum dargestellt sein. In unserem Bild müssen sie also auf derselben Galaxiekarte liegen. Embeddings aus beliebigen verschiedenen Modellen lassen sich nicht einfach miteinander vergleichen, selbst wenn ihre Zahlenlisten gleich lang sind. Eine übliche Lösung ist deshalb, für die Fragen und die Textabschnitte dasselbe geeignete Embeddingmodell zu verwenden. [2] [3]
In unserem Archivbeispiel könnte die Suche mehrere passende Textstellen liefern, etwa die Ankündigung der Bibliothekseröffnung, die Meldung über ihre Verschiebung und einen späteren Bericht über die tatsächliche Einweihung. Die Suchsoftware stellt zunächst diese Treffer bereit. Sie hat damit noch keine Antwort auf die Frage formuliert und auch nicht entschieden, welches Datum das gesuchte ist. Dafür müssen die Originaltexte mit ihrem jeweiligen Zusammenhang ausgewertet werden. Erst im nächsten Schritt erhält das LLM die ausgewählten Passagen, um daraus eine Antwort zu formulieren.
Was RAG hinzufügt
Die Verbindung aus Suche und anschließender Texterzeugung nennt man RAG. Die Abkürzung steht für Retrieval-Augmented Generation, also Texterzeugung mit zusätzlich abgerufenen Informationen. Retrieval bezeichnet das Suchen und Abrufen der passenden Inhalte. Augmentation bedeutet hier, dass die Anwendung diese Inhalte zusammen mit der Frage und den Anweisungen in den Prompt aufnimmt. Generation ist die anschließende Texterzeugung durch das LLM. RAG bezeichnet also nicht das Embeddingmodell oder die Datenbank, sondern den gesamten Ablauf, in dem abgerufene Informationen die Antwort des Sprachmodells ergänzen sollen. Für den Abruf können Embeddings verwendet werden, aber auch andere Suchverfahren, etwa eine Stichwortsuche. [5] [1] [3]
A · Archiv vorbereiten
B · Eine Frage beantworten
Vollständige Beschreibung des Schaubilds
In A bereitet die Software das Archiv vor, bevor Fragen gestellt werden. Sie teilt historische Zeitungsartikel in Textabschnitte auf, die zusammengehörige Inhalte bewahren. Ein bereits trainiertes Embeddingmodell erzeugt für jeden Abschnitt einen Zahlenvektor. Der Suchindex speichert die Vektoren mit Verknüpfungen zu den Originaltexten und ihren Fundstellen mit Zeitung, Ausgabe und Seite. Die Texte bleiben verfügbar. Diese Vorbereitung trainiert das Modell nicht.
In B fragt jemand, wann die Stadtbibliothek eröffnet wurde. Dasselbe geeignete Embeddingmodell erzeugt einen Vektor für die Frage. Die Suchsoftware vergleicht ihn mit den gespeicherten Vektoren im Index aus A und ruft ausgewählte Originalpassagen samt Fundstellen ab. Das könnten die Ankündigung, die Verschiebung und die tatsächliche Einweihung sein. Die Vektoren helfen bei der Auswahl; sie entscheiden nicht, welches Datum die Frage beantwortet.
Die Software stellt aus den Anweisungen, der Frage und den ausgewählten Originalpassagen einen Prompt zusammen. Ein separates, bereits trainiertes LLM erzeugt daraus eine Antwort. Die Zahlenvektoren gelangen nicht in den Prompt. Beide Modelle werden durch diesen Ablauf nicht trainiert. Die Fundstellen ermöglichen die Prüfung der Antwort anhand der Artikel, garantieren aber nicht ihre Richtigkeit.
Die Embeddings helfen in diesem Ablauf bei der Suche. In den Prompt kommen jedoch die Originaltexte der ausgewählten Passagen, nicht ihre Zahlenvektoren. Das LLM erhält sie zusammen mit der Frage und den Anweisungen für die Antwort. In unserem Bibliotheksarchiv könnten das beispielsweise die Meldungen zur angekündigten, verschobenen und tatsächlichen Eröffnung sein. Die Anwendung lädt also nicht das gesamte Archiv in den Prompt, sondern wählt passende Ausschnitte aus. Diese Texte belegen Platz im Kontextfenster, genau wie die Frage und der bisherige Gesprächsverlauf. Wie viele Passagen mitgegeben werden können, hängt deshalb auch vom verfügbaren Kontext ab. [1] [3]
Das LLM könnte nun anhand der gefundenen Artikel eine Antwort zur Eröffnung der Stadtbibliothek formulieren und dabei zwischen dem angekündigten Termin und der tatsächlichen Einweihung unterscheiden. Die Anwendung kann dazu die verwendeten Artikel mit Zeitung, Ausgabe und Seite nennen. So lässt sich in den Originalquellen nachsehen, ob sie das genannte Datum und die übrigen Aussagen tatsächlich belegen. Ein Quellenhinweis allein beweist das noch nicht. Auch eine Antwort mit Quellenangaben kann den Inhalt eines Artikels falsch wiedergeben oder etwas behaupten, das dort gar nicht steht. [3]
Was sich dadurch nicht im Modell ändert
In unserem Bibliotheksbeispiel übernehmen zwei separate Modelle unterschiedliche Aufgaben. Das Embeddingmodell erzeugt die Zahlenvektoren für die Archivtexte und für die Frage. Diese Vektoren verwendet die Suchsoftware, um passende Textstellen zu finden. Das antwortende Sprachmodell erhält anschließend die gefundenen Originaltexte im Prompt und formuliert daraus die Antwort. Beide Modelle wurden zuvor trainiert. Wenn das Embeddingmodell neue Artikel in Vektoren umwandelt, wendet es das bereits Gelernte an; es wird dabei nicht neu trainiert. Auch das Sprachmodell wird durch die mitgegebenen Passagen nicht trainiert. Anders als beim Training werden in diesem Ablauf keine Modellparameter verändert. Neue oder korrigierte Artikel erfordern deshalb eine Aktualisierung des Archivbestands und der zugehörigen Suchdaten, nicht automatisch ein erneutes Training der Modelle. [3]
Ein RAG-System kann trotzdem mit zusätzlichem Training verbunden werden. Das Embeddingmodell oder das antwortende Sprachmodell können gezielt weitertrainiert werden, um ihre jeweilige Aufgabe besser zu erfüllen. Eine solche Anpassung eines bereits trainierten Modells nennt man Fine-Tuning. Auch die ursprüngliche RAG-Forschungsarbeit von Lewis und Kollegen beschreibt ein System mit Fine-Tuning. Entscheidend ist deshalb die Unterscheidung zwischen zwei Vorgängen. Beim Abruf gelangen Informationen als Text in den Prompt; beim Training werden Modellparameter verändert. Beides kann in einem System vorkommen, ist aber nicht dasselbe. [4]
Auch dauerhaftes Gedächtnis ist etwas anderes. Die Zeitungsartikel bleiben verfügbar, weil die Anwendung sie in Dateien oder einer Datenbank aufbewahrt, nicht weil das Sprachmodell sie sich durch das Lesen im Prompt dauerhaft merkt. RAG ermöglicht es, bei einer späteren Frage erneut passende Inhalte abzurufen. Ob die Anwendung zusätzlich frühere Gespräche oder persönliche Angaben speichert und später wiederverwendet, hängt von ihrer Gestaltung ab. Aus „verwendet RAG“ folgt deshalb weder, dass sie sich an dich erinnert, noch dass sie keine Eingaben speichert.
In unserem Bibliotheksarchiv helfen Embeddings dabei, Artikel zur Eröffnung der Stadtbibliothek zu finden, auch wenn darin von einer „städtischen Bücherei“ die Rede ist. Das Embeddingmodell liefert dafür die Zahlenvektoren, mit denen die Suchsoftware die Frage und die Textabschnitte vergleichen kann. Das antwortende LLM erhält anschließend die gefundenen Originalpassagen und kann daraus eine Antwort formulieren, die den angekündigten Termin von der tatsächlichen Einweihung unterscheidet. RAG verbindet diese Schritte und macht einen externen Quellenbestand für die Beantwortung einer Frage nutzbar, ohne ihn dafür in die Parameter des Sprachmodells eintrainieren zu müssen.
Deeper into the Rabbit Hole
Videos auf Englisch
- Computerphile — A Helping Hand for LLMs (Retrieval Augmented Generation) — Mike Pound führt in rund 14 Minuten vom RAG-Ablauf zur praktischen Umsetzung mit einer kleinen Demonstration. Beschreibung und Kapitelübersicht wurden geprüft; das YouTube-Transkript war nicht abrufbar. Der Beitrag wurde auf Mircos Empfehlung aufgenommen. Die Folge wird von Jane Street gesponsert.
- IBM Technology — Is RAG Still Needed? Choosing the Best Approach for LLMs — Martin Keen vergleicht in rund elf Minuten RAG mit dem direkten Einlesen größerer Dokumentbestände ins Kontextfenster. Es geht um den Aufwand der Suche, übersehene Treffer und die Frage, wann ganze Dokumente sinnvoller sind als einzelne Ausschnitte. Das vollständige englische Transkript wurde gelesen, nicht das vollständige Video angesehen. Der Beitrag behandelt vor allem vektorbasiertes RAG; seine Darstellung einer Vektordatenbank als einzig möglicher Lösung für große Bestände wird hier nicht übernommen.
Quellen
- Kim Martineau, IBM Research — What is retrieval-augmented generation?, 22. August 2023. Erklärt den Abruf passender Textstellen und ihre Aufnahme in den Prompt. Behandelt auch mögliche Fehler bei Suche und Texterzeugung.
- Dale Markowitz, Google Cloud — Meet AI’s multitool: Vector embeddings, 23. März 2022. Erklärt Zahlenrepräsentationen, Ähnlichkeitsvergleiche und modellabhängige Beziehungen. Die Wortbeispiele lassen sich nicht ohne Weiteres auf Modelle für ganze Textpassagen übertragen.
- Ivan Belcic, IBM Think — What is retrieval augmented generation (RAG)?, aktualisiert am 2. Oktober 2026. Beschreibt Dokumentaufteilung, vektorbasierten Abruf, Promptergänzung und die Abgrenzung zu Fine-Tuning.
- Lewis et al. — Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, NeurIPS 2020. Die ursprüngliche Forschungsarbeit verbindet ein Sprachmodell mit einem externen Suchindex und beschreibt das Fine-Tuning des Systems. Geprüft wurde nur die Abstractseite, nicht das vollständige Paper.
- deepset / Haystack — InMemoryBM25Retriever. Beschreibt einen stichwortbasierten Abruf und zeigt ausdrücklich eine RAG-Pipeline, die gefundene Dokumente in den Prompt übernimmt und anschließend ein Sprachmodell aufruft — ohne Embeddingmodell oder Vektorsuche. Der Seiteninhalt und das Codebeispiel wurden gelesen; der Code wurde nicht ausgeführt.