Der größte Block: die Gewichte
Der größte Speicherblock eines LLM besteht aus seinen Gewichten. Das sind Zahlenwerte, die während des Trainings immer wieder angepasst wurden. Damit das Modell Text erzeugen kann, müssen diese Gewichte in einem Speicher vorgehalten werden, auf den die Recheneinheiten zugreifen können. [1]
In Modellnamen steht dafür häufig eine Angabe wie 27B. Das B steht für billion (dt. Milliarde).
Nehmen wir das beliebte Modell Qwen3.8-27B. Es besitzt rund 27 Milliarden Gewichte. Würde man diese mit 16 Bit, also zwei Byte pro Gewicht, speichern, lautet die Rechnung:
27 Milliarden × 2 Byte = ungefähr 54 Gigabyte
Ein deutlich größeres Beispiel ist DeepSeek-V4-Pro. Laut Hersteller besitzt es insgesamt 1,6 Billionen Gewichte. Davon sind für jedes Token 49 Milliarden aktiv. [2]
Bei 16 Bit würden alle Gewichte ungefähr 3,2 Terabyte belegen – knapp 60-mal so viel wie beim 27B-Modell. Dass pro Token nur ein Teil der Gewichte aktiv ist, senkt den Rechenaufwand. Dennoch müssen alle Gewichte im Speicher vorgehalten werden.
54 Gigabyte und 3,2 Terabyte beschreiben jeweils nur die Gewichte. Während das Modell rechnet, benötigt es zusätzlich Speicher für temporäre Zwischenergebnisse. Dazu kommt der KV-Cache, der mit dem verwendeten Kontext wächst.
Speicher während der Antwort
Die temporären Zwischenergebnisse bilden einen Arbeitsbereich. Seine Größe hängt von der Software, der Modellarchitektur und der jeweiligen Anfrage ab. Teile davon können nach einem Rechenschritt wieder freigegeben oder erneut verwendet werden.
Dazu kommt der KV-Cache, ausgeschrieben Key-Value-Cache. Er speichert bereits berechnete Zwischenergebnisse des bisherigen Textes. So muss das Modell diese Werte nicht für jedes neue Token erneut berechnen. [3]
Der KV-Cache ist kein zusätzliches Wissen und kein dauerhaftes Gedächtnis. Er wächst mit dem verwendeten Kontext.
Beim regulären 16-Bit-KV-Cache von Qwen3.8-27B kommen pro Token rund 64 KB hinzu. Der Wert ergibt sich aus den Full-Attention-Schichten, KV-Heads und der Head-Dimension der hier betrachteten Modellvariante. [4]
| Kontext | Berechnung pro laufender Anfrage | zusätzlicher Speicher | bei mehreren parallelen Anfragen |
|---|---|---|---|
| 32K | 32K × 64 KB | etwa 2 GB | 2 GB × Anzahl Anfragen |
| 64K | 64K × 64 KB | etwa 4 GB | 4 GB × Anzahl Anfragen |
| 128K | 128K × 64 KB | etwa 8 GB | 8 GB × Anzahl Anfragen |
| 256K | 256K × 64 KB | etwa 16 GB | 16 GB × Anzahl Anfragen |
Mehr Cache ermöglicht mehr Kontext und damit längere Abläufe, bevor ältere Inhalte entfernt oder zusammengefasst werden müssen. Bei parallelen Anfragen benötigt jede laufende Anfrage ihren eigenen Cache.
Wie viel Text ist das?
Ein Token ist weder ein einzelner Buchstabe noch immer ein vollständiges Wort. Häufige Wörter können aus einem Token bestehen, längere oder seltene Wörter aus mehreren. Deshalb lässt sich die Textmenge nur grob einordnen.
| Kontext | Wörter (ca.) | vergleichbare Textmenge |
|---|---|---|
| 32K | 20K–25K | ein Viertel von Harry Potter 1 |
| 64K | 40K–50K | die Hälfte von Harry Potter 1 |
| 128K | 80K–100K | Harry Potter 1 |
| 256K | 160K–200K | Harry Potter 1 und 2 zusammen |
Die Buchvergleiche orientieren sich an den englischen Wortzahlen und zeigen nur die Größenordnung. [5] Die tatsächliche Tokenzahl hängt von Sprache, Schreibweise und verwendetem Tokenizer ab.
Wo der Speicher liegt
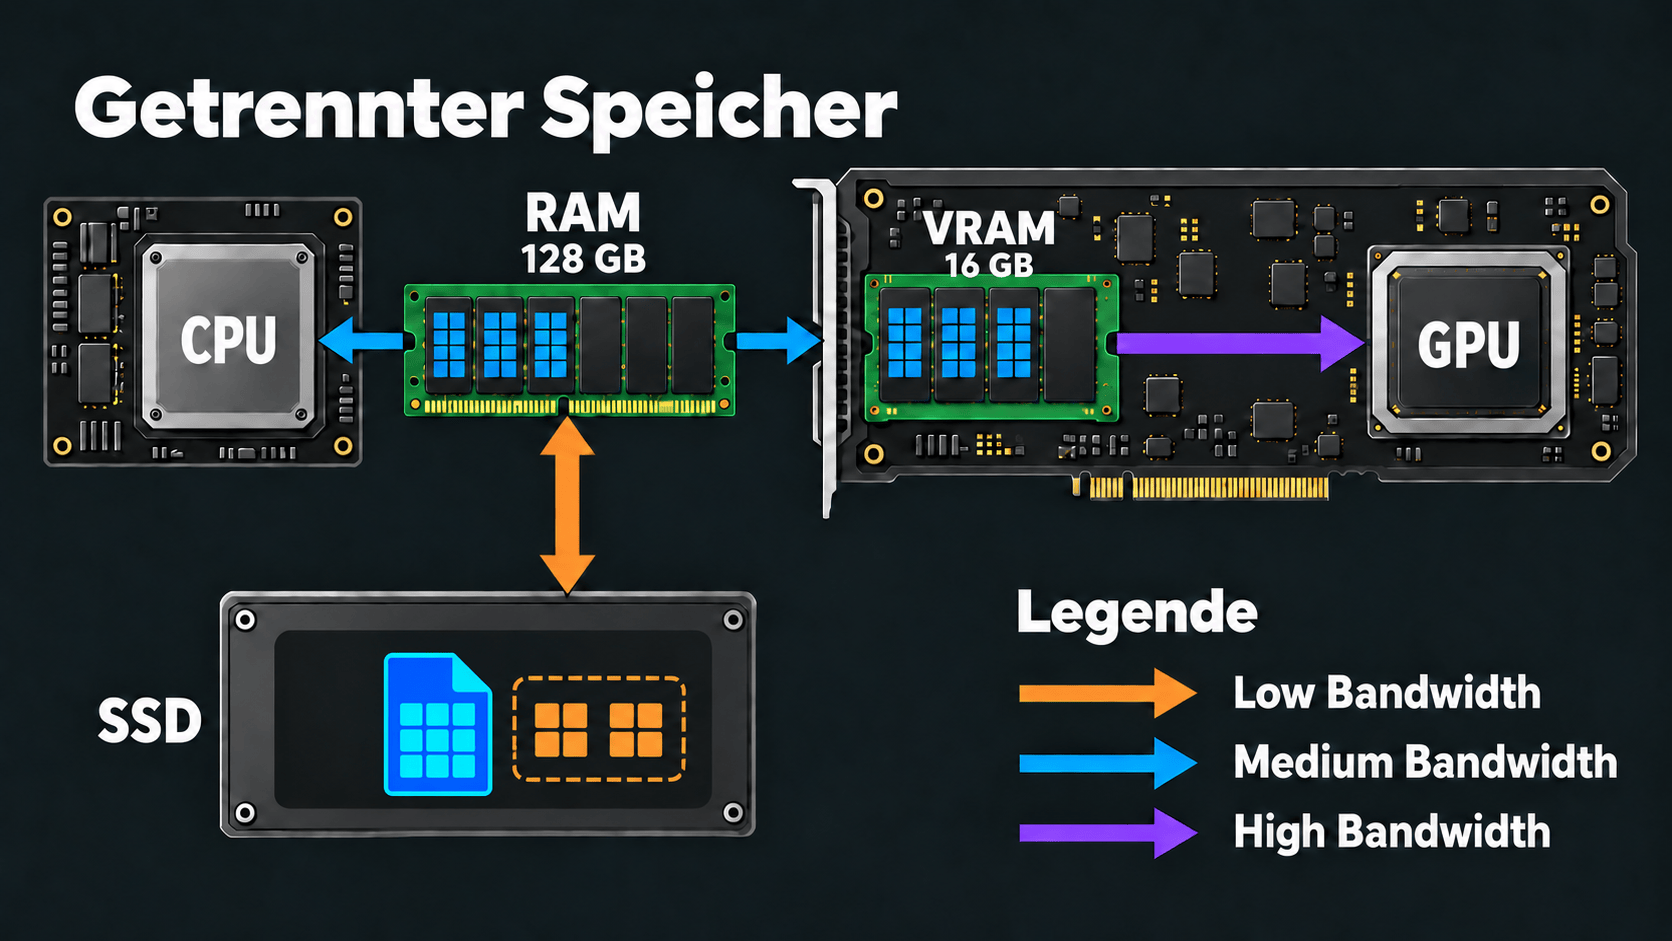
Die benötigte Speichermenge bleibt gleich, die Anordnung unterscheidet sich jedoch. Bei einem klassischen PC besitzen CPU und Grafikkarte getrennten RAM und VRAM. Daten, mit denen die GPU rechnen soll, müssen zwischen den Speicherbereichen übertragen werden. [6]
Bildinhalt als Text
Das Schaubild zeigt links eine CPU mit normalem RAM und rechts eine separate Grafikkarte mit eigenem VRAM und GPU. Blaue Pfeile verbinden CPU, RAM und VRAM; ein violetter Pfeil verbindet den schnellen VRAM mit der GPU. Unterhalb des RAM liegt eine SSD, die über einen orangefarbenen Pfeil angebunden ist. Eine Legende ordnet Orange niedriger, Blau mittlerer und Violett hoher Bandbreite zu. Die Kapazitäten von 128 GB RAM und 16 GB VRAM dienen als anschauliches Beispiel, nicht als allgemeine Vorgabe.
Bei Apple Silicon und Systemen wie dem NVIDIA DGX Spark greifen CPU und GPU dagegen auf gemeinsamen Unified Memory zu. [7] [8]
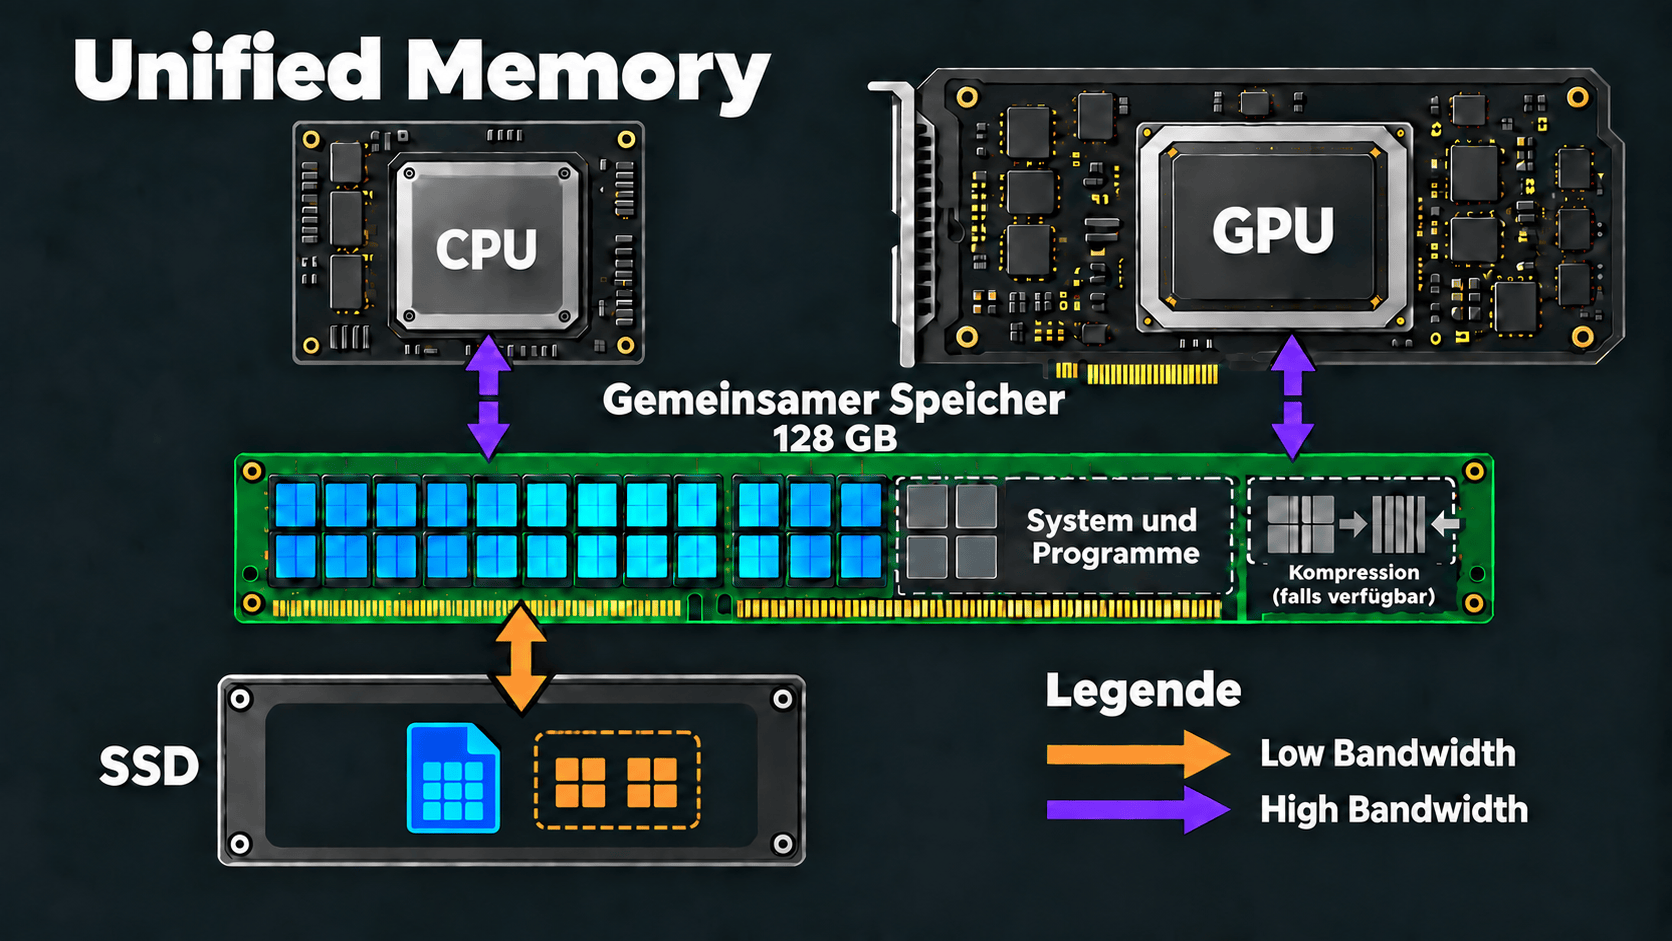
Bildinhalt als Text
Das Schaubild zeigt CPU und GPU mit violetten Pfeilen zu einem gemeinsamen Speicherpool. Ein Teil dieses Speichers ist für System und Programme belegt; außerdem ist mögliche Speicherkompression angedeutet. Eine SSD ist über einen orangefarbenen Pfeil mit niedrigerer Bandbreite angebunden. Die dargestellten 128 GB sind ein Beispiel. Entscheidend ist, dass CPU und GPU denselben Speicher nutzen und keine getrennten RAM- und VRAM-Pools dargestellt werden.
Entscheidend ist in beiden Fällen, ob Gewichte, Arbeitsdaten und KV-Cache in schnell erreichbarem Speicher bleiben. Muss das System auf die SSD auslagern, wird die Texterzeugung drastisch langsamer.
Speicher entscheidet – aber nicht allein
Ein LLM benötigt viel Speicher, weil Milliarden Gewichte bereitliegen müssen. Während der Antwort kommen Arbeitsdaten und der mit dem Kontext wachsende KV-Cache hinzu. Bei parallelen Anfragen vervielfacht sich dieser zusätzliche Bedarf.
Genügend Speicher entscheidet, ob ein Modell überhaupt laufen kann. Für die Geschwindigkeit zählt zusätzlich, wie schnell die GPU auf diese Daten zugreifen kann.
Trotzdem läuft Qwen3.8-27B auch auf Rechnern, die keine 54 Gigabyte allein für seine Gewichte bereitstellen können. Wie das funktioniert, klären wir im nächsten Kapitel: mit Quantisierung.
Deeper into the Rabbit Hole
Wenn du tiefer einsteigen möchtest, führen diese Texte und Videos die wichtigsten technischen Punkte weiter:
Texte
- Hugging Face: Optimizing LLMs for Speed and Memory – Gewichte, Datentypen und die wichtigsten Speichergrenzen bei der Inferenz.
- Hugging Face: Cache Strategies – KV-Cache, Offloading und unterschiedliche Cache-Strategien.
- Apple: Choosing a Resource Storage Mode for Apple GPUs – gemeinsamer Systemspeicher und die Zugriffswege von CPU und GPU.
- NVIDIA: DGX Spark – ein konkretes System mit 128 GB kohärentem Unified Memory.
Videos
- IBM Technology: How KV Cache Speeds Up LLMs for Faster AI Models on GPUs – ein kompakter Einstieg in KV-Cache, Prefill und Decode.
- PyTorch: Understanding the LLM Inference Workload – Mark Moyou von NVIDIA geht technischer auf Modelle, Hardware, Quantisierung und Inferenz ein.
Quellen
- Hugging Face Transformers: Optimizing LLMs for Speed and Memory.
- DeepSeek: DeepSeek-V4-Pro.
- Hugging Face Transformers: Cache Strategies.
- Hugging Face: Konfiguration der betrachteten Qwen3.8-27B-Variante.
- Word Counter: How Many Words Are in Harry Potter?.
- NVIDIA: CUDA C++ Best Practices Guide.
- Apple Developer Documentation: Choosing a Resource Storage Mode for Apple GPUs.
- NVIDIA: DGX Spark.