Was ein LLM dabei berechnet
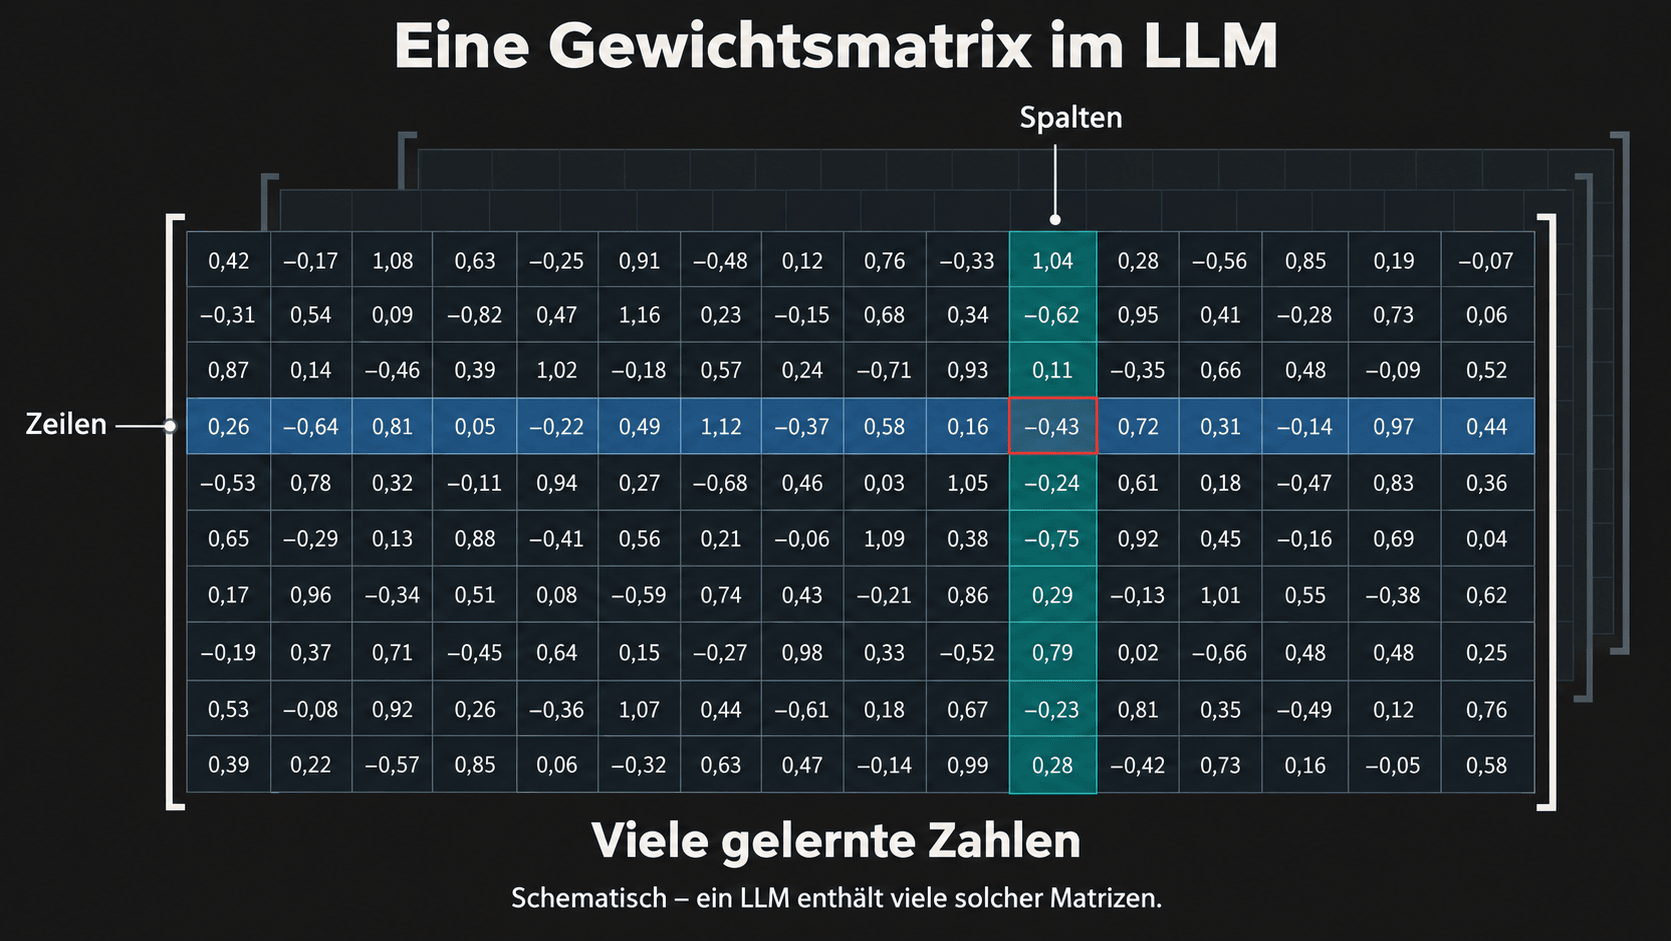
Aus dem ersten Kapitel kennen wir die Gewichte eines LLM. Das sind sehr große Tabellen aus Zahlen, in denen die beim Training gelernten Muster stecken. Eine solche rechteckige Zahlentabelle heißt in der Mathematik Matrix. Wenn ein LLM Text verarbeitet, werden diese Matrizen immer wieder miteinander verrechnet. Ein großer Teil dieser Arbeit besteht aus Multiplikationen und Additionen.
Bildinhalt als Text
Das Schaubild zeigt eine rechteckige Tabelle aus zehn Zeilen und sechzehn Spalten. Jede Zelle enthält eine positive oder negative Dezimalzahl. Eine Zeile ist blau und eine Spalte türkis hervorgehoben; ihre gemeinsame Zelle ist rot umrandet. Weitere Matrizen sind abgedunkelt im Hintergrund angedeutet. Die Zahlen stehen schematisch für Gewichte, die während des Trainings angepasst wurden. Ein LLM enthält viele solcher Matrizen.
Dabei muss dieselbe Rechenregel auf sehr viele Zahlen angewendet werden. Das Ergebnis einer einzelnen Rechnung hängt zwar von den jeweiligen Zahlen ab. Der Rechenweg bleibt aber für große Gruppen gleich. Dadurch lässt sich die Gesamtarbeit in viele kleine Pakete zerlegen, die gleichzeitig bearbeitet werden können. Genau für solchen hohen Durchsatz wurden GPUs entwickelt. [1] [2]
Wenige flexible Kerne, viele parallele Recheneinheiten
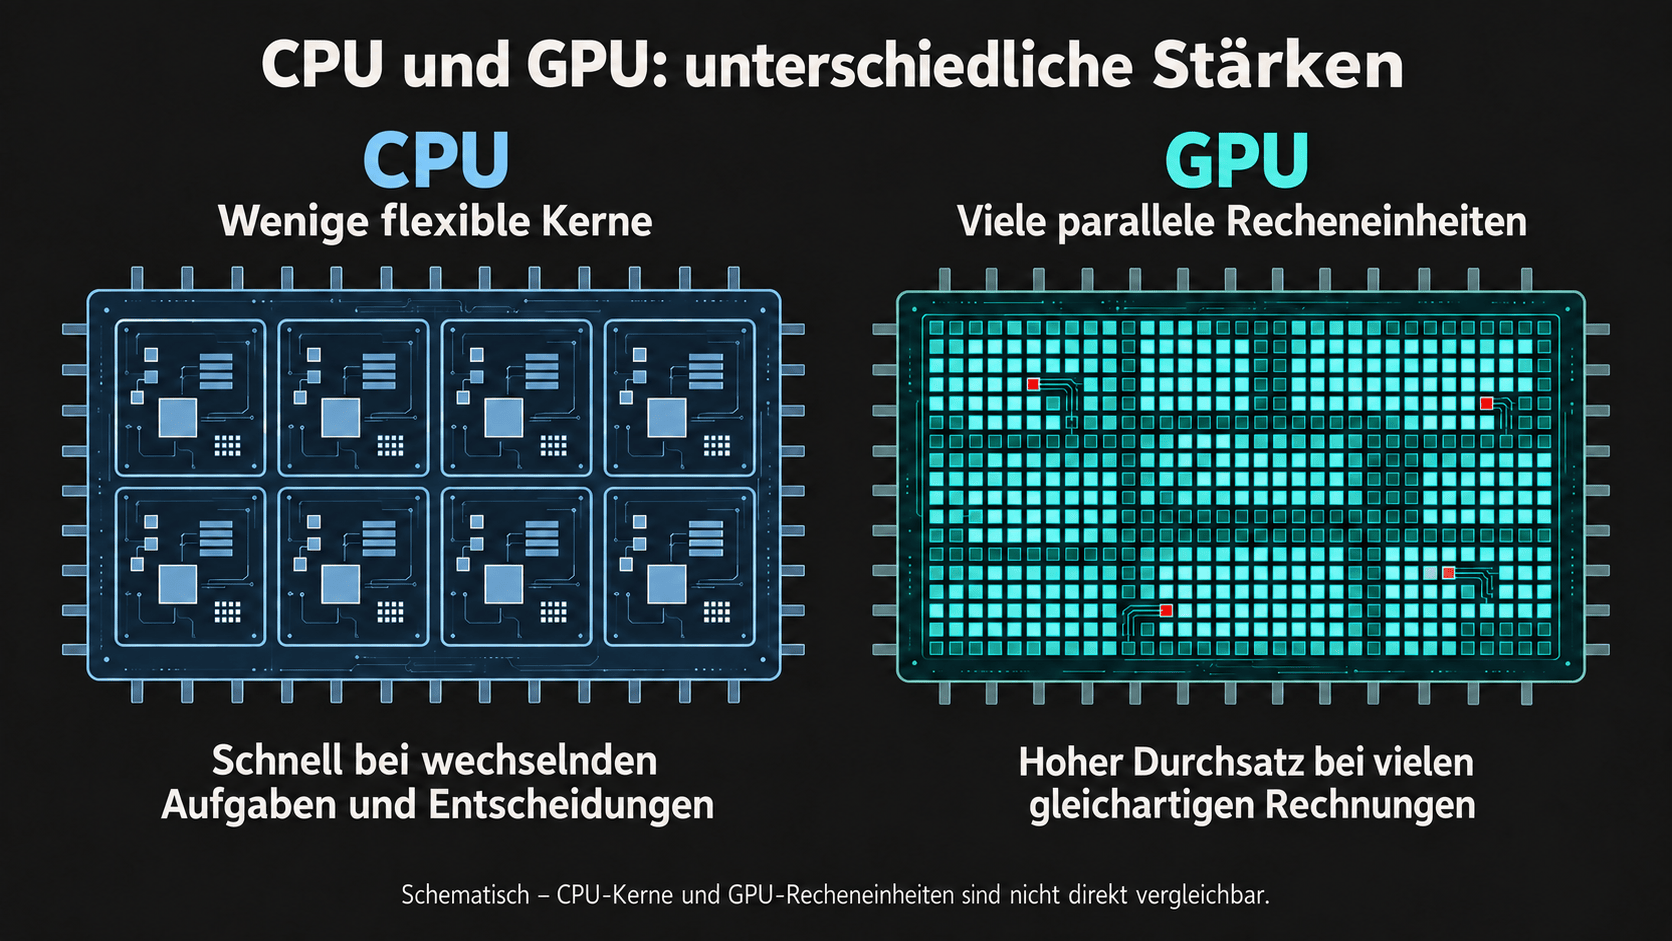
Eine CPU muss sehr unterschiedliche Aufgaben schnell erledigen. Sie führt das Betriebssystem aus, reagiert auf Eingaben und arbeitet Programme mit vielen Entscheidungen und wechselnden Abläufen ab. Dafür besitzt sie vergleichsweise wenige, sehr leistungsfähige Kerne. Diese sind darauf ausgelegt, einzelne Aufgaben mit geringer Verzögerung zu bearbeiten. [1] [2]
Eine GPU verfolgt ein anderes Ziel. Sie besitzt sehr viele einfachere Recheneinheiten und erreicht ihre Leistung, indem sie große Mengen ähnlicher Arbeit verteilt. Bei NVIDIA-GPUs werden Gruppen von Threads gemeinsam ausgeführt. Innerhalb einer solchen Gruppe läuft grundsätzlich dasselbe Programm auf unterschiedlichen Daten. Wenn alle denselben Rechenweg nehmen, ist die Hardware besonders gut ausgelastet. [3]
Das erklärt auch, warum die Anzahl der CPU- und GPU-„Kerne“ nicht direkt vergleichbar ist. Eine einzelne GPU-Recheneinheit ist kein kleiner Ersatz für einen vollständigen CPU-Kern. Die beiden Architekturen verteilen ihre Fläche und Energie auf unterschiedliche Fähigkeiten: Die CPU setzt auf schnelle, flexible Einzelarbeit, die GPU auf sehr viel gleichzeitige Rechenarbeit.
Bildinhalt als Text
Das Schaubild stellt die unterschiedlichen Stärken von CPU und GPU gegenüber. Links zeigt eine CPU acht große Kerne. Sie stehen für wenige flexible Kerne, die wechselnde Aufgaben und Entscheidungen schnell bearbeiten. Rechts zeigt eine GPU ein dichtes Raster aus vielen kleinen Recheneinheiten. Ein großer Teil davon leuchtet gleichzeitig. Das steht für hohen Durchsatz bei vielen gleichartigen Rechnungen. CPU-Kerne und GPU-Recheneinheiten sind nicht direkt miteinander vergleichbar; Anzahl und Aufbau sind schematisch dargestellt.
Warum das zu einem LLM passt
Die großen Matrixberechnungen eines LLM liefern der GPU viele gleichartige Arbeitspakete. Statt eine lange Rechnung nach der anderen abzuschließen, kann die GPU zahlreiche Teilrechnungen parallel beginnen. Ihre Stärke liegt dabei nicht im Tempo einer einzelnen Multiplikation, sondern in der Menge an Multiplikationen und Additionen, die sie zusammen abarbeiten kann.
Dieser Unterschied lässt sich als Latenz und Durchsatz beschreiben. Latenz ist die Zeit, die eine einzelne Aufgabe bis zu ihrem Ergebnis benötigt. Durchsatz beschreibt, wie viel Arbeit ein System innerhalb einer bestimmten Zeit insgesamt erledigt. CPUs sind auf niedrige Latenz bei anspruchsvoller Einzelarbeit ausgelegt. GPUs opfern einen Teil dieser Flexibilität, um bei geeigneten Aufgaben einen sehr hohen Durchsatz zu erreichen. [2]
Die Recheneinheiten müssen gefüttert werden
Viele Recheneinheiten helfen nur, wenn sie rechtzeitig neue Zahlen erhalten. Bei einer separaten Grafikkarte liegt dafür direkt an der GPU ein eigener Speicher, der VRAM. Seine hohe Bandbreite ermöglicht es, große Datenmengen schnell zwischen Speicher und Recheneinheiten zu bewegen. [3] [4]
Passt ein Modell in den VRAM, können seine Gewichte dort für die Berechnung bereitliegen. Müssen Daten dagegen ständig zwischen dem Arbeitsspeicher des Computers und der Grafikkarte übertragen werden, kostet das Zeit. Bei kleinen Aufgaben kann dieser Aufwand den Geschwindigkeitsvorteil der GPU sogar vollständig aufzehren. [2]
Warum die GPU nicht immer schneller ist
Nicht jede Aufgabe lässt sich in viele gleichartige Pakete zerlegen. Manche Berechnungen bauen Schritt für Schritt aufeinander auf. Andere enthalten viele Abzweigungen, bei denen verschiedene Teile unterschiedliche Anweisungen ausführen müssen. Auf einer GPU bleiben dann Recheneinheiten ungenutzt oder müssen aufeinander warten. Kleine Aufgaben können außerdem zu wenig Arbeit liefern, um den Aufwand für Start, Verteilung und Datentransfer auszugleichen. [3] [4]
Auch ein stark parallelisiertes Programm behält meist Teile, die nacheinander ausgeführt werden müssen. Diese seriellen Anteile begrenzen, wie stark das gesamte Programm durch mehr parallele Recheneinheiten beschleunigt werden kann. Hinzu kommen Aufwand für Kommunikation, Koordination und Datenbewegung. [5]
CPU und GPU sind deshalb kein Entweder-oder. Die CPU steuert den allgemeinen Programmablauf, bereitet Arbeit vor und übernimmt Aufgaben, die Flexibilität oder schnelle Einzelreaktionen verlangen. Die GPU bearbeitet die großen, passenden Rechenblöcke. Bei einem LLM ist diese Arbeitsteilung besonders wirksam, weil seine Matrixberechnungen sehr viel parallele Arbeit bereitstellen.
Deeper into the Rabbit Hole
Wenn du tiefer einsteigen möchtest, führen diese Texte und Videos die wichtigsten technischen Punkte weiter:
Texte
- NVIDIA: CUDA C++ Best Practices Guide – Parallelität, Datentransfers, Speicherzugriffe und die Grenzen praktischer GPU-Beschleunigung.
- AMD ROCm: Understanding GPU Performance – Rechenleistung, Speicherbandbreite und Overhead als mögliche Engpässe.
- Lawrence Livermore National Laboratory: Introduction to Parallel Computing Tutorial – eine herstellerunabhängige Einführung in Parallelisierung und ihre Grenzen.
Videos
- Computerphile: CPU vs GPU (What’s the Difference?) – eine kurze und verständliche Gegenüberstellung.
- Branch Education: How do Graphics Cards Work? Exploring GPU Architecture – eine ausführliche Visualisierung von GPU, Recheneinheiten und Grafikspeicher.
- Stanford CS149: GPU Architecture and CUDA Programming – eine technische Universitätsvorlesung zur Vertiefung.
Quellen
- Intel: CPU vs. GPU: What’s the Difference?.
- NVIDIA: CUDA C++ Best Practices Guide.
- NVIDIA: CUDA Programming Guide — Programming Model.
- AMD ROCm: Understanding GPU Performance.
- Lawrence Livermore National Laboratory: Introduction to Parallel Computing Tutorial.