Ein LLM zerlegt Text in kleine Abschnitte, die Tokens heißen. Sie entsprechen nicht immer ganzen Wörtern. Ein Token kann ein Wort, ein Wortteil oder ein Satzzeichen sein. Für das Beispiel in diesem Artikel vereinfachen wir das. Wir behandeln jedes Wort und jedes Satzzeichen als eigenes Token. So lässt sich das Grundprinzip leichter zeigen.
Das Training
Am Anfang steht ein untrainiertes Modell. Es bekommt sehr viele Texte zu sehen und soll immer wieder vorhersagen, wie ein Text weitergeht. Jede Vorhersage wird mit der tatsächlichen Fortsetzung verglichen. Danach werden die inneren Einstellungen des Modells ein kleines Stück angepasst. Dieser Vorgang wiederholt sich sehr oft. So lernt das Modell nach und nach, welche Fortsetzungen in welchem Zusammenhang wahrscheinlich sind.
Bei diesem Training werden riesige Tabellen voller Zahlen immer wieder angepasst. Diese Zahlen heißen Gewichte. Um ihre Aufgabe zu verstehen, schauen wir kurz auf den Aufbau des Modells: Es verarbeitet Informationen in vielen miteinander verbundenen Rechenknoten. Diese nennt man oft künstliche Neuronen. Die Gewichte bestimmen, wie stark die Verbindungen zwischen diesen Knoten wirken.
Die Gewichte bilden gemeinsam die Muster ab, die das Modell beim Training gelernt hat. Dazu gehört zum Beispiel, wie englische Sätze aufgebaut sind und welche Wörter häufig miteinander vorkommen. Beim Verarbeiten eines Textes verbindet das Modell diese gelernten Muster mit dem jeweiligen Kontext. So kann dasselbe Wort je nach Zusammenhang unterschiedlich eingeordnet werden.
Nach diesem ersten Trainingsschritt kann das Modell Texte fortsetzen, ist aber noch nicht automatisch ein brauchbarer Chatbot. Deshalb wird es häufig mit Beispielen weitertrainiert, die jeweils aus einer Anweisung und einer dazugehörigen Antwort bestehen. Dadurch werden Ausgaben wahrscheinlicher, die Fragen beantworten, Aufgaben bearbeiten oder einem gewünschten Format folgen.
Anschließend werden häufig zwei Antworten des Modells miteinander verglichen und nach vorgegebenen Kriterien bewertet. Das können Menschen übernehmen, aber auch andere Modelle oder automatische Prüfverfahren. Diese Bewertungen dienen als Grundlage für ein weiteres Training. Dabei werden die Gewichte so angepasst, dass Ausgaben, die den besser bewerteten Antworten ähneln, künftig wahrscheinlicher werden. Das macht eine Antwort für Menschen oft hilfreicher oder gefälliger, aber nicht automatisch faktisch richtig.
Wie ein trainiertes LLM antwortet
Wenn ein trainiertes LLM eine Antwort erzeugt, nennt man das Inferenz. Das Modell verarbeitet den gesamten Text, den du in das Chatfenster eingegeben hast. Mithilfe seiner gelernten Gewichte berechnet es für jedes mögliche nächste Textstück einen Wert. Das Ergebnis können wir uns als große Tabelle vorstellen: Manche Fortsetzungen sind sehr wahrscheinlich, viele andere äußerst unwahrscheinlich.
Vereinfacht ähnelt diese Tabelle Amazons „Andere Kunden kauften auch“. Dort lautet die Frage: „Was kauften Menschen, die dieses Produkt angesehen haben?“ Beim LLM lautet sie sinngemäß: „Was schrieben Menschen nach einem ähnlichen Text wahrscheinlich als Nächstes?“
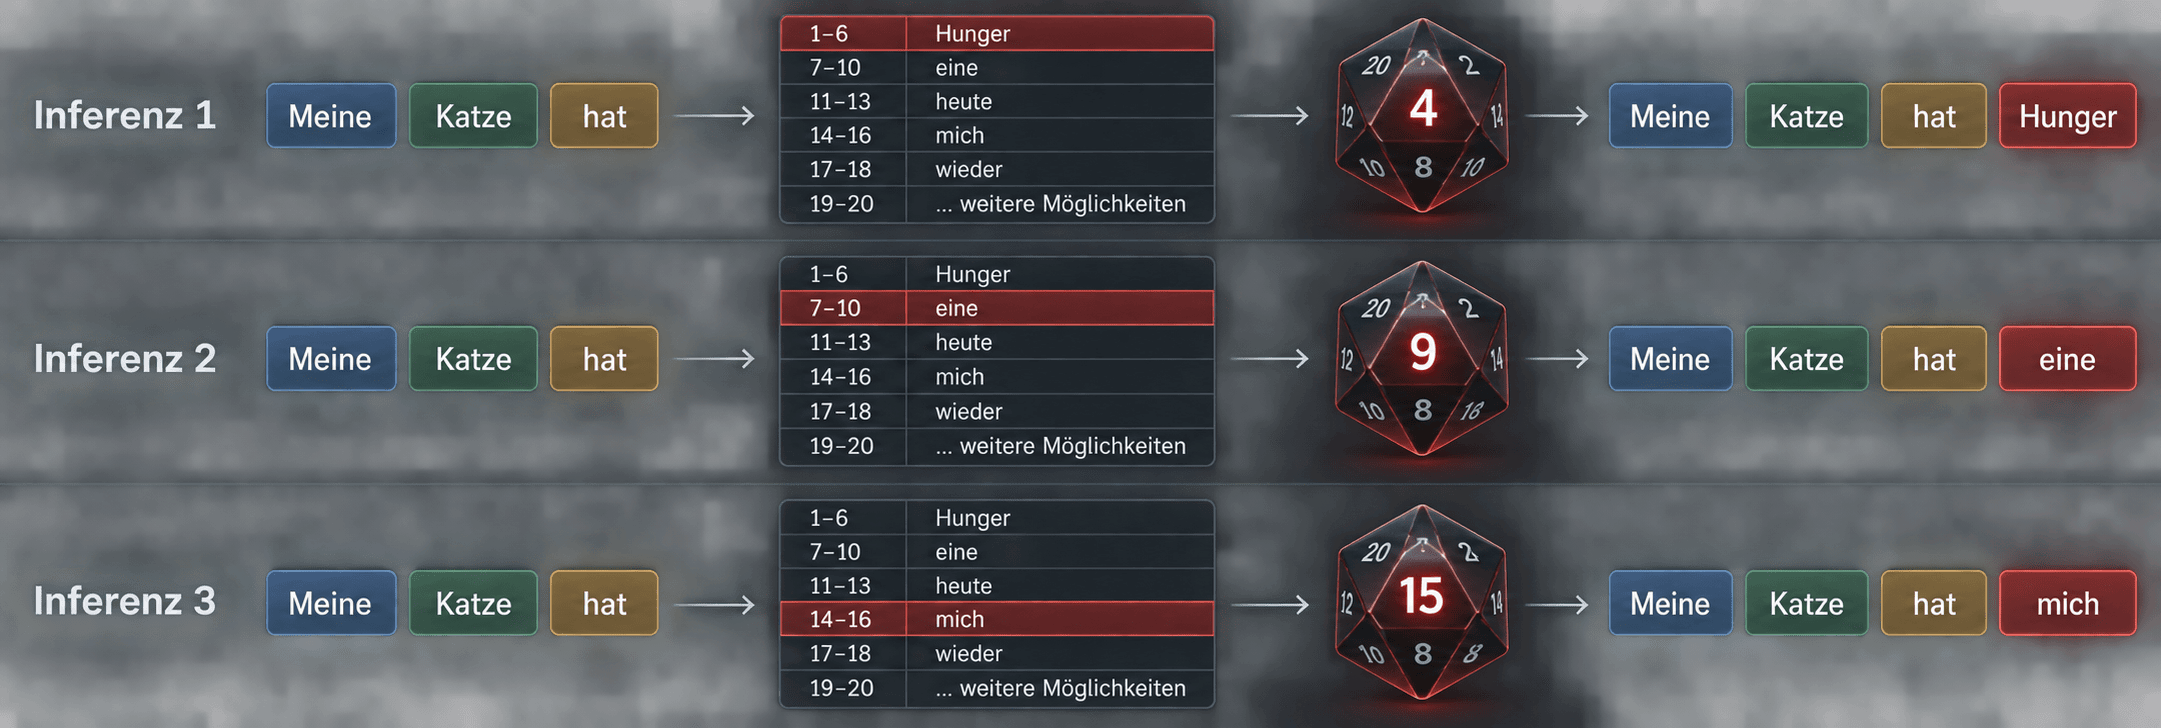
Um diese gewichtete Auswahl sichtbar zu machen, übertragen wir sie in unserem Beispiel auf einen W20, einen Würfel mit den Zahlen 1 bis 20. Die fünf wahrscheinlichsten Fortsetzungen erhalten jeweils einen passenden Zahlenbereich. Alle weiteren Möglichkeiten fassen wir in einer sechsten Tabellenzeile zusammen. Je größer der Zahlenbereich ist, desto wahrscheinlicher wird die Fortsetzung ausgewählt.
Wir schicken den Text „Meine Katze hat“ dreimal unabhängig an dasselbe Modell. Weil alle drei Inferenzen mit demselben Text beginnen, verwenden sie dieselbe erste Tabelle. Der W20 fällt jedoch jedes Mal anders und wählt dadurch drei verschiedene Fortsetzungen aus. Im Bild verfolgen wir sie als Inferenz 1, Inferenz 2 und Inferenz 3.
Bildinhalt als Text
Alle drei Inferenzen beginnen mit „Meine Katze hat“. Die gemeinsame W20-Tabelle lautet: 1 bis 6 = „Hunger“, 7 bis 10 = „eine“, 11 bis 13 = „heute“, 14 bis 16 = „mich“, 17 bis 18 = „wieder“, 19 bis 20 = weitere Möglichkeiten.
- Inferenz 1 würfelt 4 und ergänzt „Hunger“.
- Inferenz 2 würfelt 9 und ergänzt „eine“.
- Inferenz 3 würfelt 15 und ergänzt „mich“.
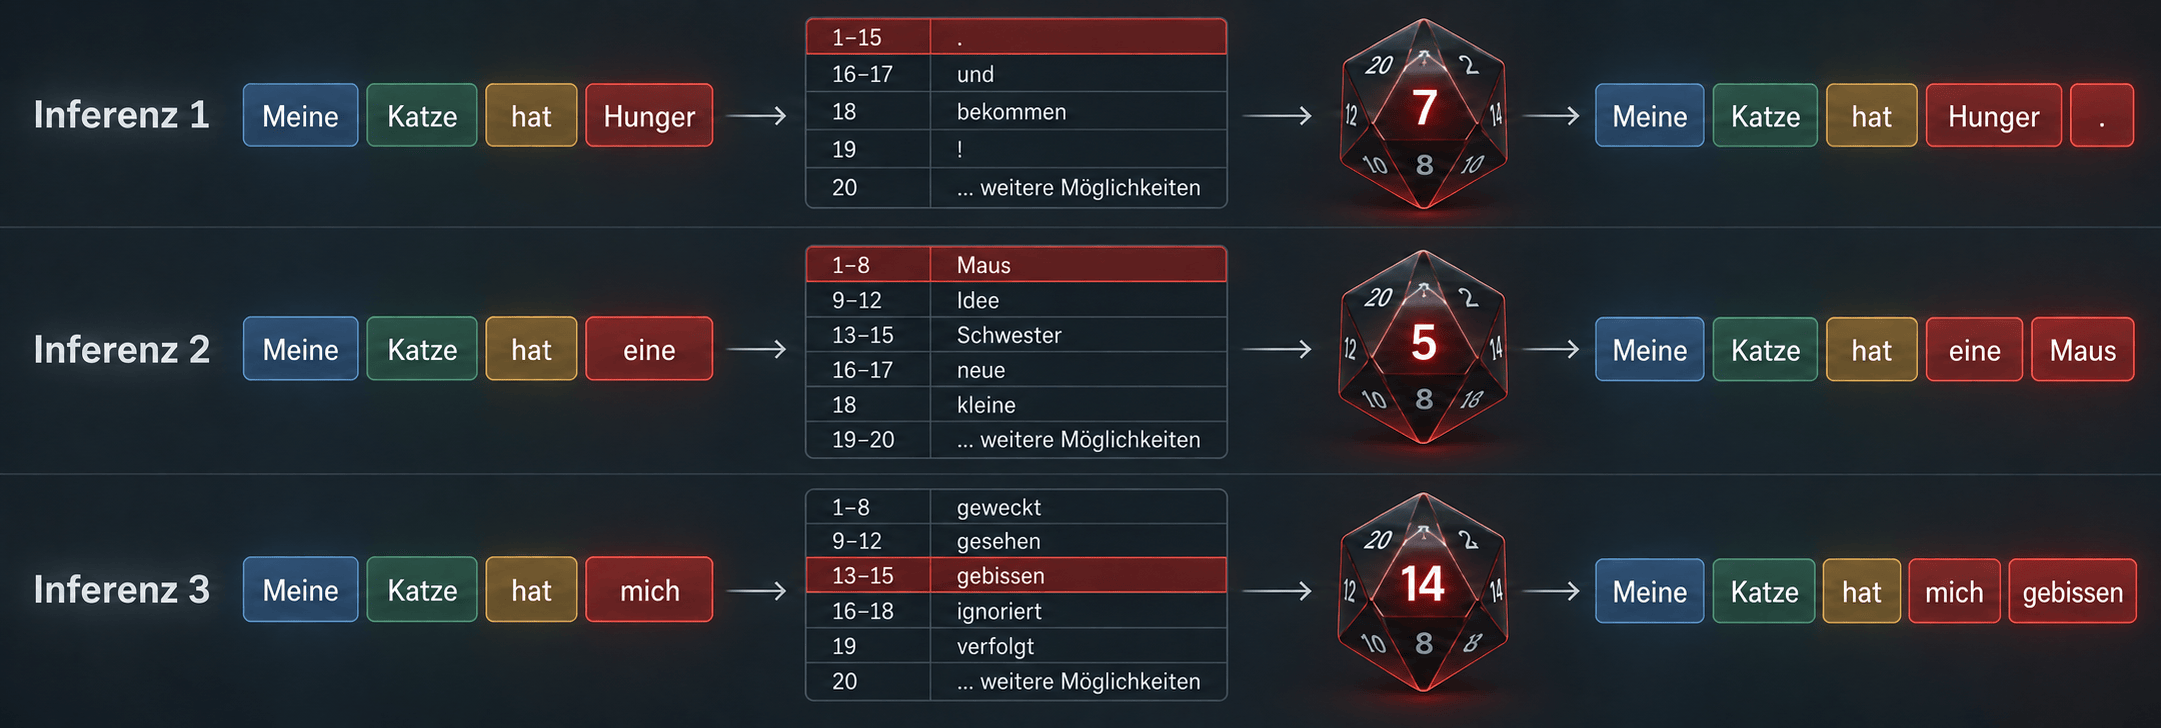
In unseren drei Inferenzen hat der erste Würfelwurf jeweils ein anderes Wort ausgewählt. Dieses Wort wird an den bisherigen Text angehängt. Für den nächsten Schritt verwendet das Modell wieder den gesamten bisherigen Text, nicht nur das neue Wort. Weil sich die drei Texte jetzt unterscheiden, entstehen auch drei verschiedene Tabellen mit anderen Fortsetzungen und Gewichtungen.
Bildinhalt als Text
- Inferenz 1, „Meine Katze hat Hunger“: 1 bis 15 = Punkt, 16 bis 17 = „und“, 18 = „bekommen“, 19 = Ausrufezeichen, 20 = weitere Möglichkeiten. Der Wurf 7 wählt den Punkt.
- Inferenz 2, „Meine Katze hat eine“: 1 bis 8 = „Maus“, 9 bis 12 = „Idee“, 13 bis 15 = „Schwester“, 16 bis 17 = „neue“, 18 = „kleine“, 19 bis 20 = weitere Möglichkeiten. Der Wurf 5 wählt „Maus“.
- Inferenz 3, „Meine Katze hat mich“: 1 bis 8 = „geweckt“, 9 bis 12 = „gesehen“, 13 bis 15 = „gebissen“, 16 bis 18 = „ignoriert“, 19 = „verfolgt“, 20 = weitere Möglichkeiten. Der Wurf 14 wählt „gebissen“.
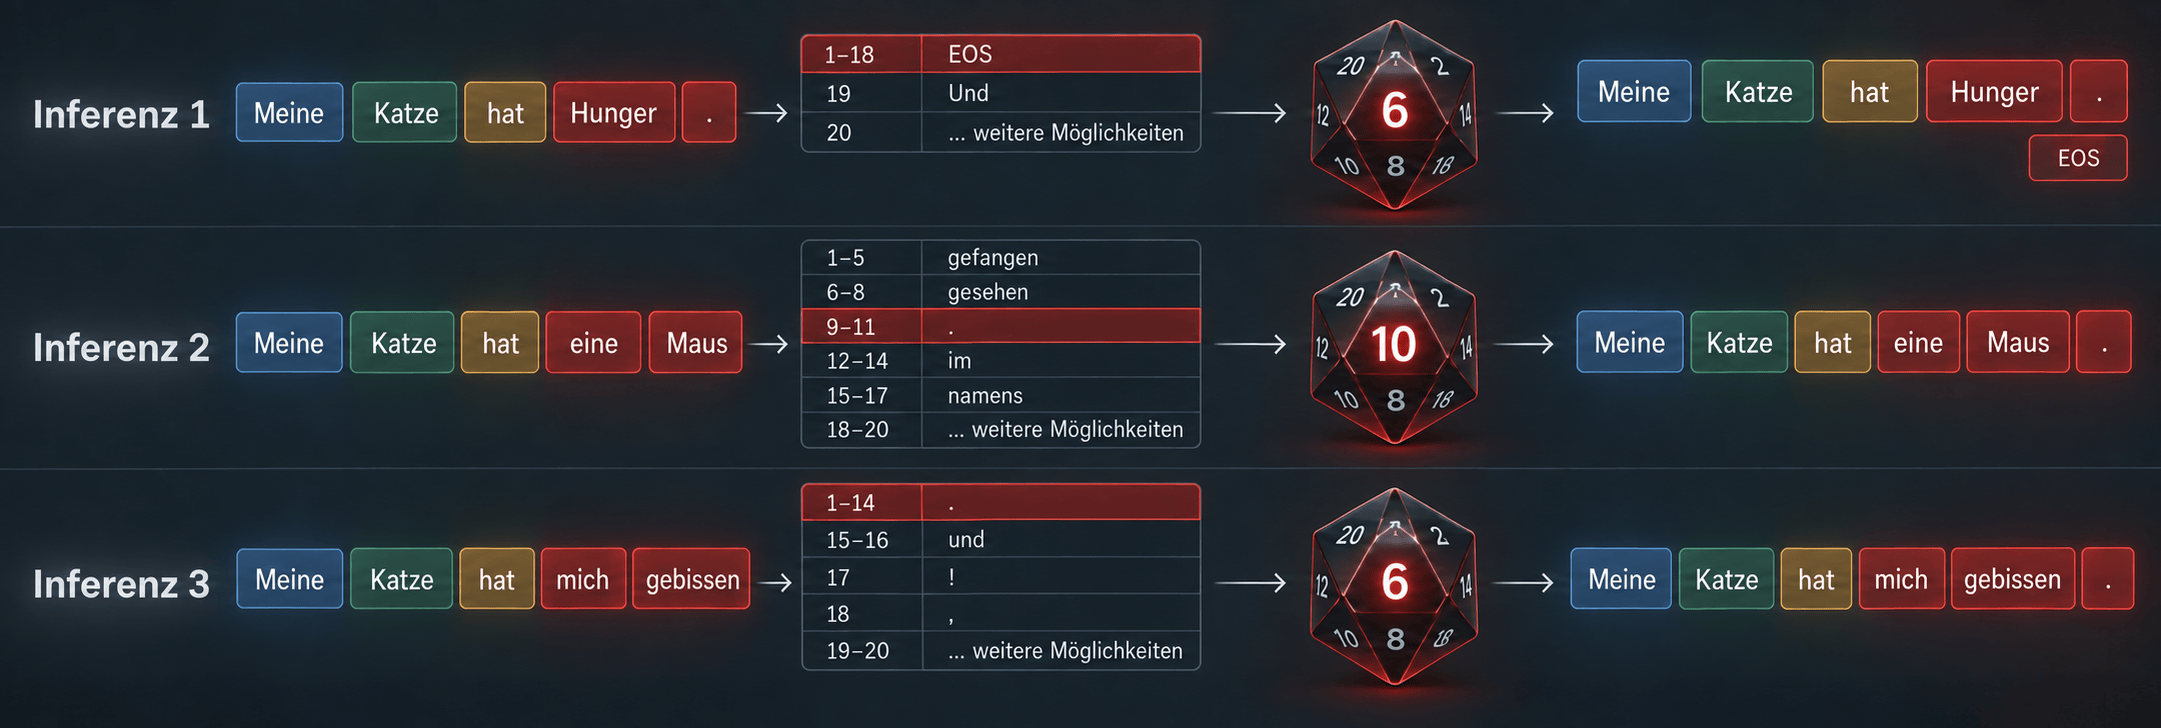
Nun wird in jeder Inferenz erneut gewürfelt. Dabei können die neuen Tabellen sehr unterschiedlich aussehen. In einer verteilt sich die Wahrscheinlichkeit auf mehrere mögliche Wörter, während in einer anderen fast alle Würfelwerte zur gleichen Fortsetzung führen. Im dritten Bild führen wir die drei Sätze noch einen Schritt weiter und schließen sie ab.
Bildinhalt als Text
- Inferenz 1, „Meine Katze hat Hunger.“: 1 bis 18 = EOS, 19 = „Und“, 20 = weitere Möglichkeiten. Der Wurf 6 wählt EOS und beendet die Inferenz.
- Inferenz 2, „Meine Katze hat eine Maus“: 1 bis 5 = „gefangen“, 6 bis 8 = „gesehen“, 9 bis 11 = Punkt, 12 bis 14 = „im“, 15 bis 17 = „namens“, 18 bis 20 = weitere Möglichkeiten. Der Wurf 10 wählt den Punkt.
- Inferenz 3, „Meine Katze hat mich gebissen“: 1 bis 14 = Punkt, 15 bis 16 = „und“, 17 = Ausrufezeichen, 18 = Komma, 19 bis 20 = weitere Möglichkeiten. Der Wurf 6 wählt den Punkt.
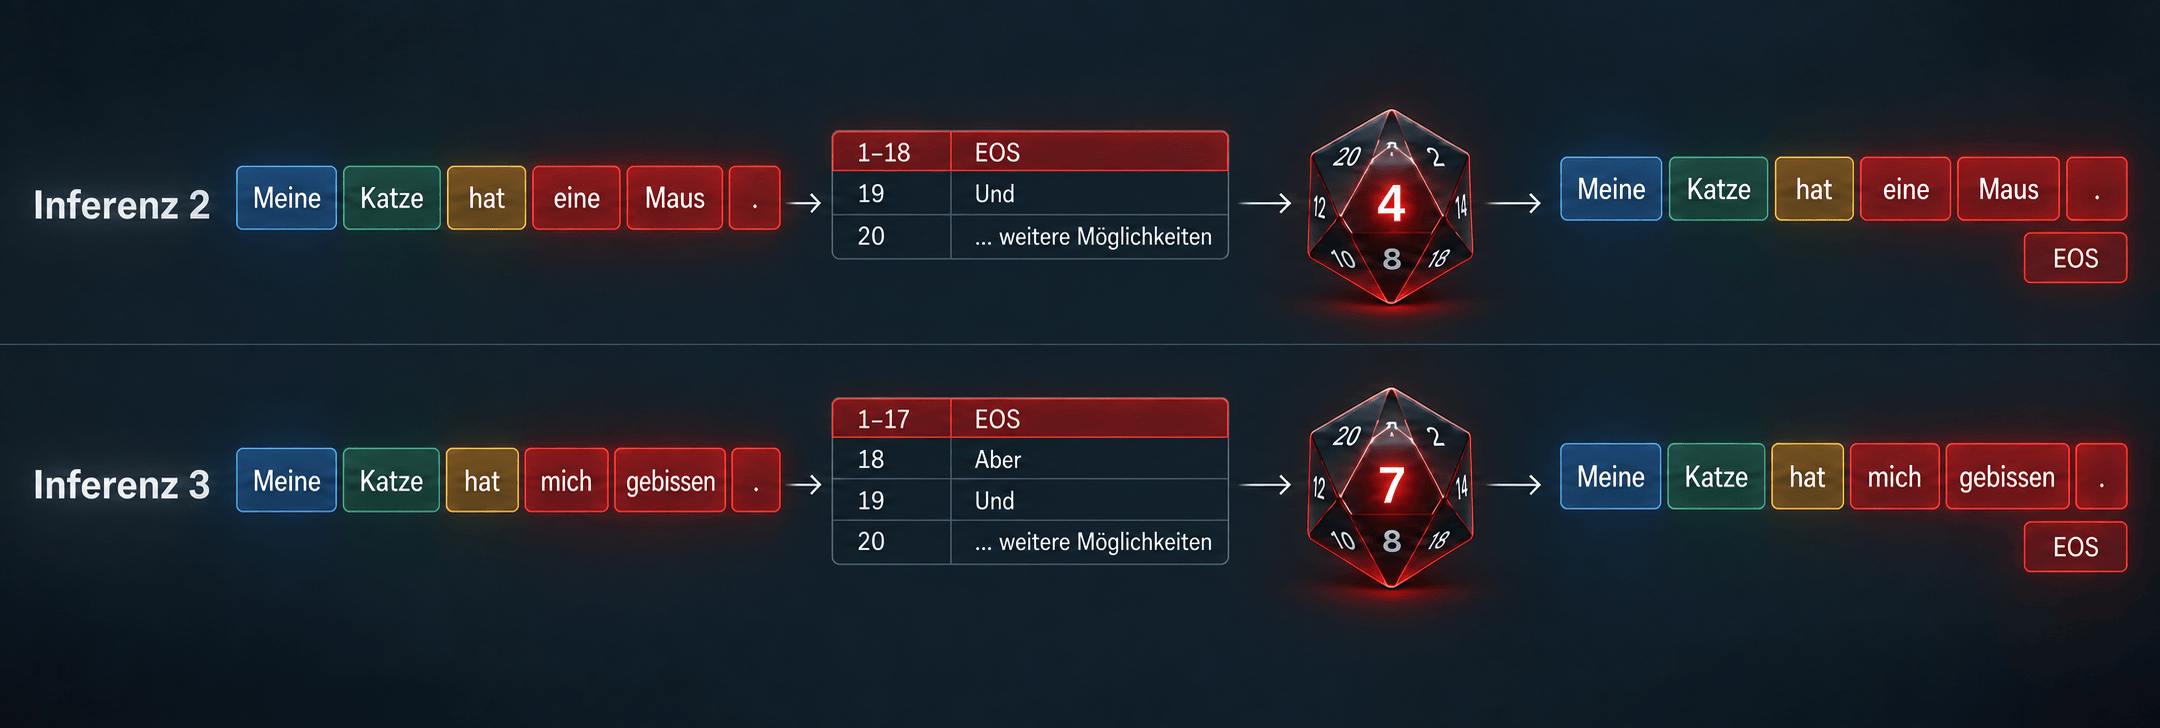
Diese Berechnung wiederholt sich Textstück für Textstück. Normalerweise endet sie, wenn das Modell ein besonderes Ende-Token auswählt, häufig EOS für „End of Sequence“. Dieses Token gehört nicht zur sichtbaren Antwort. Inferenz 1 ist nun beendet.
Bildinhalt als Text
- Inferenz 2, „Meine Katze hat eine Maus.“: 1 bis 18 = EOS, 19 = „Und“, 20 = weitere Möglichkeiten. Der Wurf 4 wählt EOS.
- Inferenz 3, „Meine Katze hat mich gebissen.“: 1 bis 17 = EOS, 18 = „Aber“, 19 = „Und“, 20 = weitere Möglichkeiten. Der Wurf 7 wählt EOS.
Nun haben auch Inferenz 2 und Inferenz 3 ein EOS-Token ausgewählt. Damit sind alle drei Inferenzen beendet. Die Chatsoftware hat den erzeugten Text empfangen und zeigt ihn als Antwort an. Viele Chatoberflächen zeigen die Antwort bereits während ihrer Entstehung Textstück für Textstück. Eine Inferenz kann auch ohne EOS enden, etwa wenn die festgelegte Höchstlänge erreicht ist oder du die Ausgabe abbrichst.
Wenn du danach eine weitere Nachricht in den Chat schreibst, stellt die Chatsoftware eine neue Anfrage zusammen. Sie kombiniert den bisherigen Gesprächsverlauf mit deiner neuen Nachricht und schickt alles erneut an das LLM. Das LLM selbst erinnert sich nicht an die vorherige Anfrage. Die scheinbare Erinnerung entsteht dadurch, dass die Chatsoftware den bisherigen Verlauf erneut mitsendet.
Die steuernde Software: das Harness
Die Chatsoftware aus unserem Beispiel ist bereits eine einfache Form eines Harness. So nennt man die steuernde Software um ein LLM. Sie stellt Anfragen zusammen, schickt sie an das Modell, nimmt dessen Ausgaben entgegen und entscheidet, was als Nächstes damit geschieht. Das LLM erzeugt Text; das Harness organisiert den Ablauf.
Ein einfaches Harness verwaltet vor allem den Chatverlauf und die Anfragen an das LLM. Ausgefeiltere Varianten können zusätzliche Anweisungen einfügen, die Erzeugung der Antwort steuern und dem LLM ermöglichen, Aufrufe anderer Software anzufordern. Dadurch kann dasselbe LLM weit mehr tun als in einem einfachen Chat.
Für jede Inferenz stellt das Harness eine vollständige Anfrage zusammen. Sie kann zusätzliche Anweisungen, den bisherigen Gesprächsverlauf, Informationen über verfügbare Software und Ergebnisse früherer Aufrufe enthalten. Das Harness kann außerdem Einstellungen vorgeben, etwa wie lang die Antwort höchstens werden darf. Das LLM erhält nur die Informationen und Möglichkeiten, die das Harness ihm für diese Anfrage bereitstellt.
Das LLM kann in seiner Ausgabe einen Aufruf anderer Software anfordern. Das Harness erkennt diese Anforderung, führt den Aufruf aus und fügt das Ergebnis in die nächste Anfrage ein. Anschließend startet es eine neue Inferenz. Das LLM führt die Software also nicht selbst aus; es erzeugt lediglich eine hoffentlich passende Anforderung.
Der Agent
Ein LLM wird erst zusammen mit einem Harness und angebundener Software zu einem Agenten. Das LLM erzeugt die Ausgaben, das Harness steuert den Ablauf und die angebundene Software führt die angeforderten Aktionen aus.
Bekannte Beispiele für solche Agentensysteme sind OpenClaw und Hermes Agent. Sie bleiben über eine Oberfläche erreichbar und können Aufgaben über mehrere Inferenzen und Softwareaufrufe hinweg bearbeiten. Dadurch wirken sie eigenständiger als ein gewöhnlicher Chatbot. Technisch bestehen sie weiterhin aus einem LLM, einem Harness, angebundener Software und den Zugriffsrechten, die Menschen ihnen eingeräumt haben.
Deeper into the Rabbit Hole
Wenn du tiefer in die Technik hinter LLMs einsteigen möchtest, findest du bei 3Blue1Brown besonders anschauliche mathematische Erklärungen. Computerphile erklärt Informatik und LLMs eher im Gespräch. Beide Kanäle sind englischsprachig.
- Transformers, the tech behind LLMs – 3Blue1Brown
- Attention in transformers, step-by-step – 3Blue1Brown
- Ch(e)at GPT? – Computerphile
- Why AI Tokens are so Expensive – Computerphile