Aus feinen werden gröbere Abstufungen
Im vorigen Kapitel ging es um eine einfache Frage: Warum braucht ein Sprachmodell so viel Speicher? Der größte Teil besteht aus seinen Gewichten. Das sind Milliarden Zahlen, die beim Training angepasst wurden und die das Modell für seine Berechnungen benötigt. Während es eine Antwort erzeugt, kommen weitere Daten für die laufende Arbeit und den bisherigen Text hinzu.
Als Beispiel haben wir Qwen3.8-27B betrachtet, ein Modell mit rund 27 Milliarden Gewichten. Würde man jede dieser Zahlen mit 16 Bit – also zwei Byte – speichern, bräuchten die Gewichte allein ungefähr 54 Gigabyte. Nicht jeder Rechner kann so viel schnellen Speicher nur dafür bereitstellen. Und trotzdem gibt es Varianten, die auch auf manchen Consumer-Endgeräten laufen. Wie funktioniert das?
Die Antwort beginnt bei einer Methode namens Quantisierung. Sie lässt die Gewichte nicht verschwinden, sondern speichert angenäherte Werte mit weniger Platz. Dabei ändern sich Zahlen, mit denen das Modell rechnet. Warum entstehen danach überhaupt noch brauchbare Ergebnisse? Und wann merkt man die Änderung?
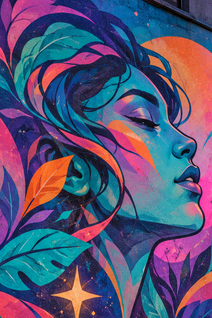
Stell dir ein buntes Graffiti vor. Mit vielen Farbabstufungen sind die Übergänge im Gesicht und in den Haaren fein. Stehen nur noch wenige Farben zur Verfügung, bleiben Gesicht und Haare erkennbar, aber feine Unterschiede verschwinden. Genau das zeigt der Bildvergleich direkt darunter. Es fehlen dabei keine Bildpunkte; die Abstufungen zwischen den Farben werden gröber.
 16 Bit
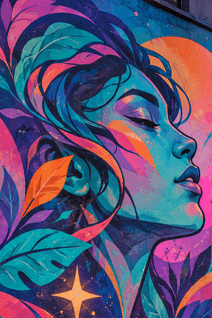 8 Bit
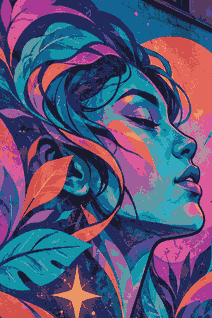 4 Bit
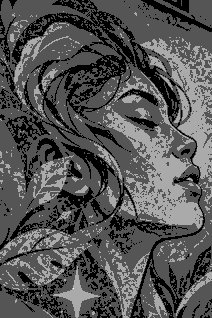 2 Bit · vier Graustufen
Bildinhalt als Text
Alle vier Ansichten zeigen denselben engen Ausschnitt einer Graffiti-Wand: ein Gesicht im Profil mit geschlossenen Augen, geschwungenen Haaren und Blättern. Die ersten beiden Ansichten sind bunt und unterscheiden sich nur wenig. Die dritte zeigt größere einfarbige Flächen und weniger feine Übergänge. Die vierte zeigt das Motiv mit nur vier Graustufen. Gesicht und Haare bleiben erkennbar; viele kleine Farb- und Helligkeitsunterschiede fehlen. Das ist ein Bildbeispiel für gröbere Abstufungen, keine Ausgabe quantisierter Sprachmodelle.
Bei den Gewichten betrifft die Änderung Zahlen statt Farben. Ein Gewicht könnte beispielsweise den Wert −0,723 haben. In einem stark vereinfachten Beispiel lässt sich an seiner Stelle nur −0,72 speichern. Wie fein solche Werte unterschieden werden können, nennen wir hier Präzision. Die Zahl wird angenähert – ähnlich wie beim Runden auf weniger Nachkommastellen. Das bedeutet jedoch nicht, dass eine bestimmte Bitzahl genau einer festen Anzahl von Nachkommastellen entspricht.
Die Software ordnet den Gewichten einer Gruppe kleinere gespeicherte Codes zu. Eine Umrechnungsregel verbindet diese Codes mit angenäherten Zahlenwerten. Auf diese Weise können auch negative und größere Werte dargestellt werden. Je weniger Bits für einen Code vorgesehen sind, desto weniger Abstufungen stehen innerhalb seines Bereichs zur Verfügung. Wie gut die Annäherung gelingt, hängt von der gewählten Methode und den tatsächlichen Werten ab. [1] [2]
Warum rechnet das Modell weiter?
Im Artikel Wie funktioniert ein LLM? haben wir beschrieben, wie ein Modell mögliche nächste Wortteile bewertet und daraus eine Fortsetzung auswählt. Hier schauen wir einen Schritt früher in denselben Ablauf: Woher kommen diese Bewertungen, wenn die Gewichte gerundet wurden?
Die Gewichte sind weiterhin da. Das Modell verarbeitet denselben bisherigen Text und verwendet nun angenäherte Zahlen in seinen Rechenschritten. Aus ihnen entstehen weiterhin Bewertungen für dieselben möglichen Wortteile. Die geringere Bitzahl eines gespeicherten Gewichts verkleinert nicht den Wortschatz des Modells. Sie kann verändern, wie hoch einzelne Fortsetzungen bewertet werden.
Ein stark verkleinertes Zahlenbild zeigt zwei Möglichkeiten. Zunächst liegt A mit 8,2 deutlich vor B mit 4,1. Nach der Annäherung stehen 8,0 und 4,2: Die Werte haben sich geändert, A bleibt aber vorn. In einem zweiten Fall liegen A und B vorher bei 8,2 und 8,1. Danach können 8,0 und 8,2 herauskommen – die Reihenfolge kippt. Die Zahlen sind erfundene Bewertungen zur Erklärung, keine Wahrscheinlichkeiten und keine Messung an Qwen. Der tatsächliche Einfluss lässt sich aus ihnen nicht vorhersagen.
Wie viel Platz wird frei?
Für unser Beispiel mit rund 27 Milliarden Gewichten lässt sich der reine Platzbedarf leicht überschlagen:
| Speicher pro Gewicht | Rechnerischer Platz für 27 Milliarden Gewichte |
|---|---|
| 16 Bit | etwa 54 GB |
| 8 Bit | etwa 27 GB |
| 4 Bit | etwa 13,5 GB |
| 2 Bit | etwa 6,75 GB |
Diese Tabelle beschreibt nur eine idealisierte Gewichtsrechnung. Sie verspricht weder entsprechend große fertige Modelldateien noch gleiche Qualität und Geschwindigkeit bei allen vier Stufen. Die Zweibit-Zeile veranschaulicht eine besonders starke Verkleinerung; sie belegt nicht, dass eine entsprechende Variante dieses Modells praktisch brauchbar ist.
Die lokal geprüfte Qwen3.8-27B-Variante belegt mit ihren Modelldateien rund 30,9 GB, obwohl viele ihrer Gewichte quantisiert gespeichert sind. Nicht jede Komponente nutzt acht Bit; manche bleiben in höherer Genauigkeit erhalten. Hinzu kommen Daten, die für die Umrechnung benötigt werden. Auch beim Betrieb braucht das Modell weiterhin zusätzlichen Speicher für die laufende Arbeit und den KV-Cache, den wir im Artikel Warum braucht ein LLM so viel Speicher? erklärt haben. Die kleinere Datei ist also keine vollständige Rechnung über den Speicherbedarf eines laufenden Modells. Die Dateigröße wurde am lokalen Snapshot geprüft; die öffentliche Modellkonfiguration beschreibt die gemischten Zahlenformate. [3]
Kleiner heißt nicht automatisch gleich gut oder schnell
Weniger Speicherplatz hat einen Preis: Die Gewichte sind nur noch angenähert. Dadurch können sich Antworten ändern. Ob das im Alltag auffällt, hängt vom Modell, der Quantisierung und der Aufgabe ab. Die Bitzahl allein verrät nicht, wie gut eine Variante antwortet. Die Ergebnisse einer konkreten Variante müssen geprüft werden. [2] [4] [5]
Kleiner heißt auch nicht automatisch schneller. Es kann helfen, wenn das Modell dadurch in den verfügbaren schnellen Speicher passt. Die Software und die Hardware müssen das Format aber gut verarbeiten können. Deshalb lohnt sich ein Vergleich am konkreten Modell statt einer allgemeinen Regel wie „4 Bit ist schneller als 8 Bit“. [1] [2]
Quantisierung löst damit ein sehr konkretes Problem: Sie kann die Gewichte so verkleinern, dass ein Modell auf einem geeigneten Rechner überhaupt oder besser im verfügbaren Speicher läuft. Sie nimmt dem Modell nicht seine Kandidaten für das nächste Wortteil, und sie macht aus fehlerhaften Aussagen keine korrekten. Sie tauscht Speicherplatz gegen eine Annäherung der Gewichte, deren Folgen man am konkreten Modell beurteilen muss.
Deeper into the Rabbit Hole
Wenn du genauer verstehen möchtest, wie Verfahren und Hardware zusammenspielen, findest du hier weiterführende Texte und Videos:
Texte
- Maarten Grootendorst: A Visual Guide to Quantization – anschauliche Stufen und Zahlenbeispiele; später deutlich technischer als dieses Kapitel.
- llama.cpp: Quantize – dokumentierte Größen, Qualitätsmessungen und Geschwindigkeiten konkreter lokaler Formate.
- Google AI Edge: Post-training quantization – warum Format und unterstützte Rechenoperationen für die Ausführung zählen.
Videos
- Matt Williams: Optimize Your AI – Quantization Explained – lokales Modell, Bitstufen und Auswahl einer passenden Variante.
- IBM Technology: LLM Compression Explained – Speicher, Geschwindigkeit und Grenzen der Verkleinerung.
Quellen
- Google AI Edge: Post-training quantization.
- ggml-org / llama.cpp: Quantize.
- Hugging Face: Konfiguration der betrachteten Qwen3.8-27B-Variante. Die rund 30,9 GB Modelldateien wurden am lokalen Snapshot gemessen.
- Dettmers et al.: LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale.
- Frantar et al.: GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers.