
Wie wir in „Wie funktioniert ein LLM?“ gezeigt haben, entsteht eine Antwort Token für Token. Welches Textstück als Nächstes angehängt wird, können wir uns als gewichteten Würfelwurf vorstellen. Wahrscheinliche Fortsetzungen bekommen mehr Würfelzahlen zugeteilt als unwahrscheinliche. Die Einstellung Temperature, auf Deutsch Temperatur, verändert diese Gewichtung. Sie bestimmt damit, wie stark die Favoriten beim Würfeln bevorzugt werden. [1]
Wie in Artikel 01 behandeln wir Tokens im Beispiel vereinfacht als ganze Wörter. Tatsächlich können sie auch Wortteile oder Satzzeichen sein. Unser W20 steht für die zufällige Auswahl aus den berechneten Wahrscheinlichkeiten, nicht für einen echten Würfel im Computer.
Temperature verändert die Gewichtung
Wir beginnen wieder mit „Meine Katze hat“. In unserem erfundenen Beispiel ist „Hunger“ die wahrscheinlichste Fortsetzung. Bei niedriger Temperature wird dieser Favorit stärker bevorzugt. Er erhält einen größeren Zahlenbereich auf unserem W20. Weniger wahrscheinliche Fortsetzungen bekommen kleinere Bereiche.
Bei höherer Temperature werden die Unterschiede kleiner. Schwächere Kandidaten erhalten mehr Chancen, der Favorit bleibt aber der Favorit. Temperature kehrt die Rangfolge nicht um. Ein seltener ausgewähltes Wort ist deshalb weder automatisch besser noch besonders kreativ. [1]
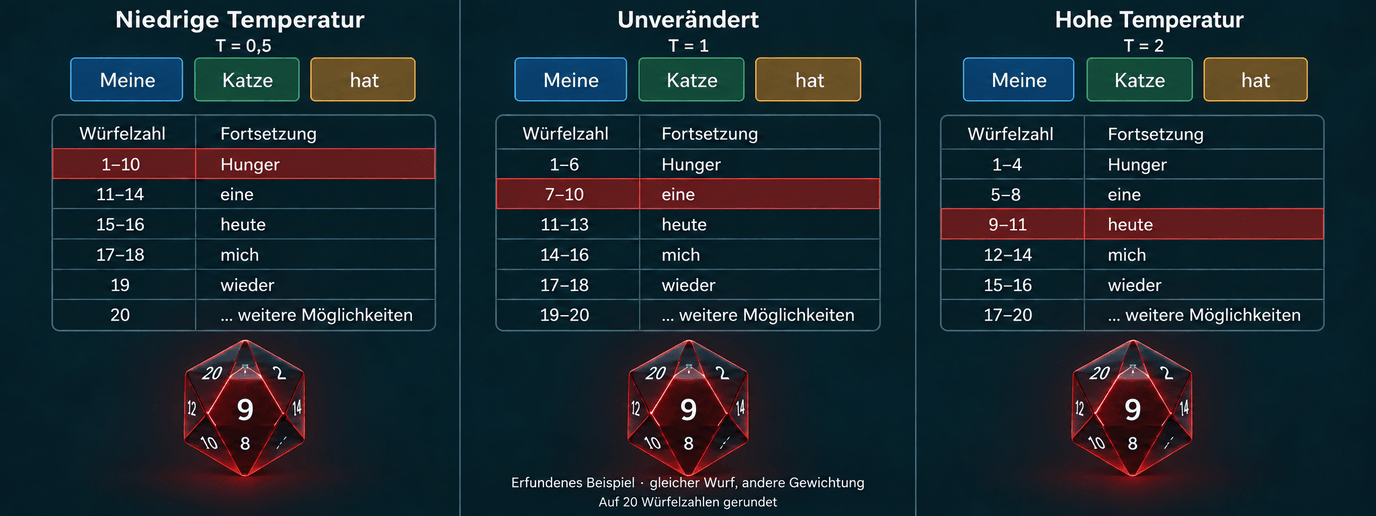
Das Bild vergleicht Temperature 0,5, 1 und 2. Bei 1 bleibt die ursprüngliche Gewichtung unverändert. Das bedeutet nicht, dass 1 in jeder Software die Standardeinstellung ist. Wir verwenden überall denselben Wurf 9, damit die veränderten Zahlenbereiche sichtbar werden. [2]
Bildinhalt als Text
Alle drei Spalten beginnen mit „Meine Katze hat“. Die Fortsetzungen lauten in gleicher Reihenfolge „Hunger“, „eine“, „heute“, „mich“, „wieder“ und weitere Möglichkeiten.
- Temperature 0,5. Die Bereiche sind 1 bis 10, 11 bis 14, 15 bis 16, 17 bis 18, 19 und 20. Der Wurf 9 wählt „Hunger“.
- Temperature 1. Die Bereiche sind 1 bis 6, 7 bis 10, 11 bis 13, 14 bis 16, 17 bis 18 und 19 bis 20. Der Wurf 9 wählt „eine“.
- Temperature 2. Die Bereiche sind 1 bis 4, 5 bis 8, 9 bis 11, 12 bis 14, 15 bis 16 und 17 bis 20. Der Wurf 9 wählt „heute“.
Die Ausgangswahrscheinlichkeiten sind erfunden. Sie betragen 30, 20, 15, 15 und 10 Prozent für die fünf genannten Wörter sowie jeweils 5 Prozent für zwei weitere Kandidaten. Temperature wird auf die einzelnen Kandidaten angewandt. Erst danach werden die beiden weiteren Kandidaten zusammengefasst. Die Zahlenbereiche sind auf 20 Würfelzahlen gerundet. Die Werte sind keine Modellmessungen.
Die Würfelgewichtung meint hier die Chancen bei der Auswahl, nicht die beim Training gespeicherten Modellgewichte. Temperature ist kein Regler für Intelligenz oder Wahrheit. Bei Temperature 0 verwenden viele Anwendungen statt eines zufälligen Wurfs die wahrscheinlichste Fortsetzung. Das garantiert nicht in jeder Umgebung identische vollständige Antworten. [2]
Top-p begrenzt die Auswahl
Während Temperature die Gewichtung verändert, bestimmt Top-p, welche Fortsetzungen überhaupt berücksichtigt werden. Dazu werden die Kandidaten nach ihrer Wahrscheinlichkeit geordnet. Beginnend mit dem Favoriten werden so viele aufgenommen, bis ihre gemeinsame Wahrscheinlichkeit mindestens den eingestellten Wert erreicht. [3]
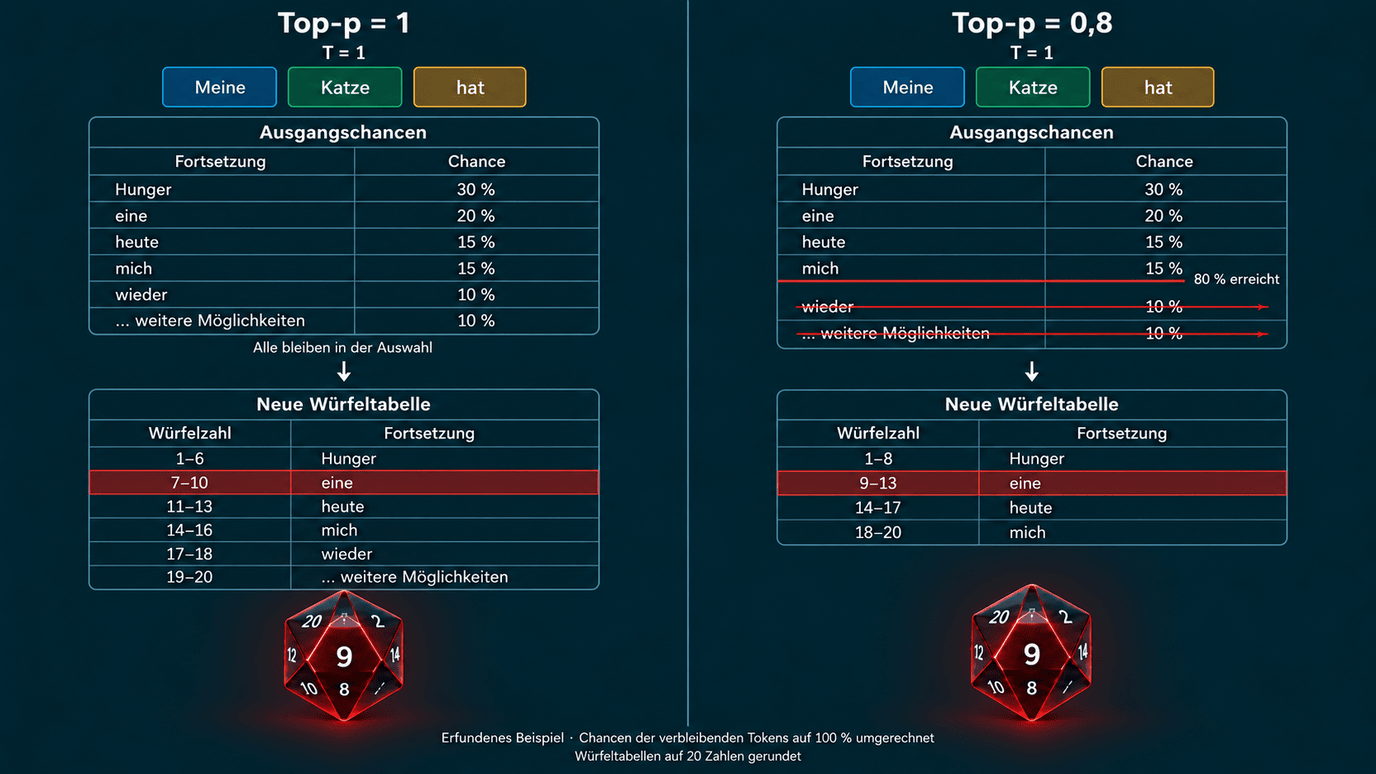
Bei Top-p = 0,8 sind das in unserem Beispiel „Hunger“ mit 30 Prozent, „eine“ mit 20 Prozent sowie „heute“ und „mich“ mit jeweils 15 Prozent. Zusammen erreichen sie 80 Prozent. „Wieder“ und die weiteren Möglichkeiten bleiben bei diesem Schritt außerhalb der Auswahl.
Die verbliebenen Chancen werden auf zusammen 100 Prozent umgerechnet. Sie werden nicht gleich groß. „Hunger“ bleibt wahrscheinlicher als „eine“. Top-p = 0,8 bedeutet also nicht, dass 80 Prozent aller Tokens übrig bleiben. Je nach Verteilung können wenige oder viele Kandidaten nötig sein, um die Grenze zu erreichen. Bei Top-p = 1 entfällt diese Begrenzung. [2] [3]
Bildinhalt als Text
Beide Spalten beginnen mit „Meine Katze hat“ bei Temperature 1. Die erfundenen Ausgangschancen sind „Hunger“ 30 Prozent, „eine“ 20 Prozent, „heute“ 15 Prozent, „mich“ 15 Prozent, „wieder“ 10 Prozent und weitere Möglichkeiten zusammen 10 Prozent.
- Top-p 1 lässt alle Kandidaten in der Auswahl. Die Bereiche lauten 1 bis 6 für „Hunger“, 7 bis 10 für „eine“, 11 bis 13 für „heute“, 14 bis 16 für „mich“, 17 bis 18 für „wieder“ und 19 bis 20 für weitere Möglichkeiten.
- Top-p 0,8 erreicht nach „mich“ die Grenze von 80 Prozent. „Wieder“ und weitere Möglichkeiten sind durchgestrichen. Nach dem Umrechnen auf 100 Prozent lauten die gerundeten Bereiche 1 bis 8 für „Hunger“, 9 bis 13 für „eine“, 14 bis 17 für „heute“ und 18 bis 20 für „mich“.
Beide Würfel zeigen 9 und wählen „eine“. Ein veränderter Filter muss bei einem einzelnen Wurf nicht zu einem anderen Ergebnis führen. Alle Beispiele sind erfunden und auf 20 Zahlen gerundet.
Top-k begrenzt die Anzahl
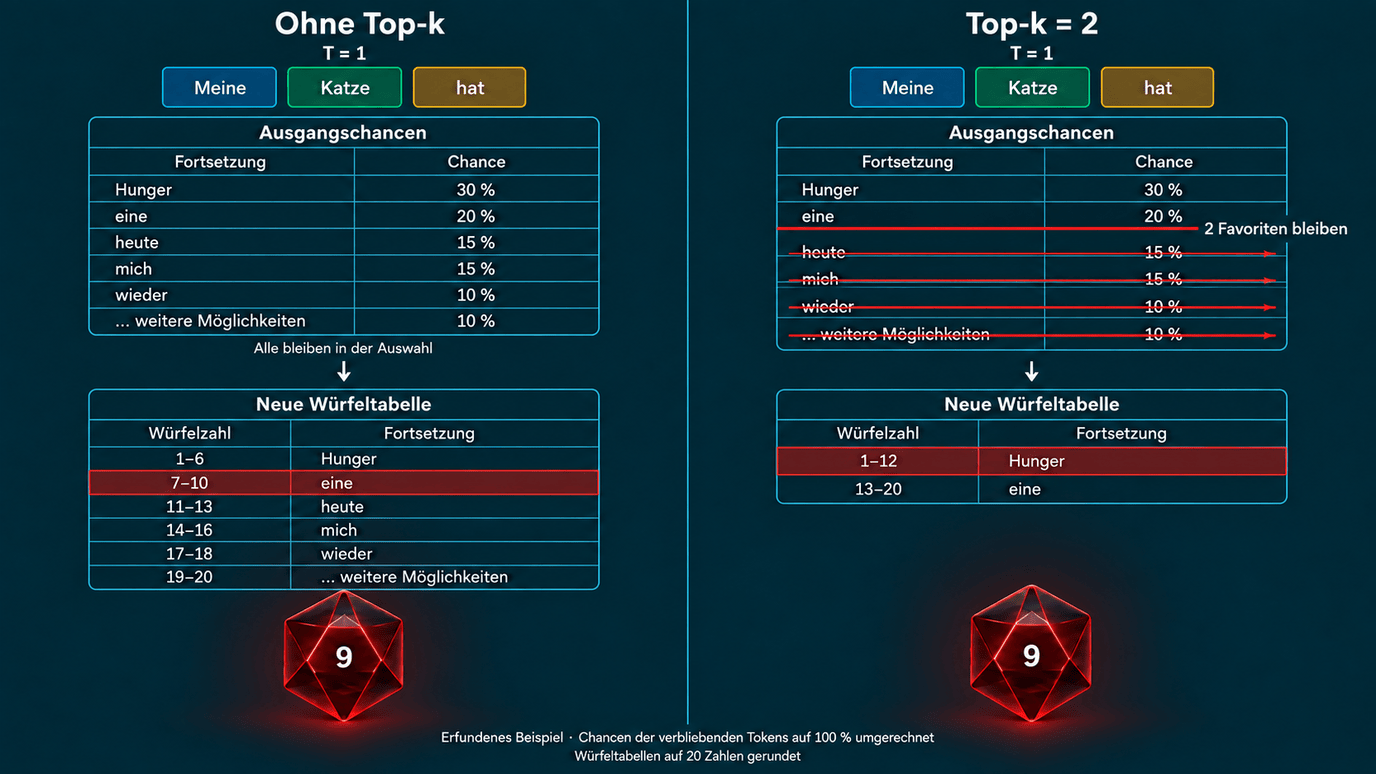
Top-k bestimmt, wie viele der wahrscheinlichsten Fortsetzungen zur Auswahl stehen. Bei Top-k = 2 bleiben in unserem Beispiel nur „Hunger“ und „eine“ übrig. Anders als Top-p setzt Top-k also eine feste Anzahl statt einer Wahrscheinlichkeitsgrenze. [2]
Die übrigen Fortsetzungen werden ausgeschlossen. Die Chancen der beiden Favoriten werden auf zusammen 100 Prozent umgerechnet, bleiben aber unterschiedlich groß. Auf unserem W20 erhält „Hunger“ dadurch zwölf Zahlen und „eine“ acht.
Bildinhalt als Text
Beide Spalten beginnen mit „Meine Katze hat“ bei Temperature 1. Die erfundenen Ausgangschancen sind „Hunger“ 30 Prozent, „eine“ 20 Prozent, „heute“ 15 Prozent, „mich“ 15 Prozent, „wieder“ 10 Prozent und weitere Möglichkeiten zusammen 10 Prozent.
- Ohne Top-k bleiben alle Kandidaten. Die Bereiche sind 1 bis 6 für „Hunger“, 7 bis 10 für „eine“, 11 bis 13 für „heute“, 14 bis 16 für „mich“, 17 bis 18 für „wieder“ und 19 bis 20 für weitere Möglichkeiten.
- Top-k 2 behält nur „Hunger“ und „eine“. Die vier übrigen Zeilen sind durchgestrichen. Die Chancen werden von zusammen 50 Prozent auf 100 Prozent umgerechnet. „Hunger“ erhält 60 Prozent und die Zahlen 1 bis 12, „eine“ 40 Prozent und die Zahlen 13 bis 20.
Beide Würfel zeigen 9. Ohne Filter wird „eine“ ausgewählt, mit Top-k 2 „Hunger“. Das Bild zeigt ein erfundenes Beispiel, keine Modellmesswerte.
Min-p vergleicht mit dem Favoriten
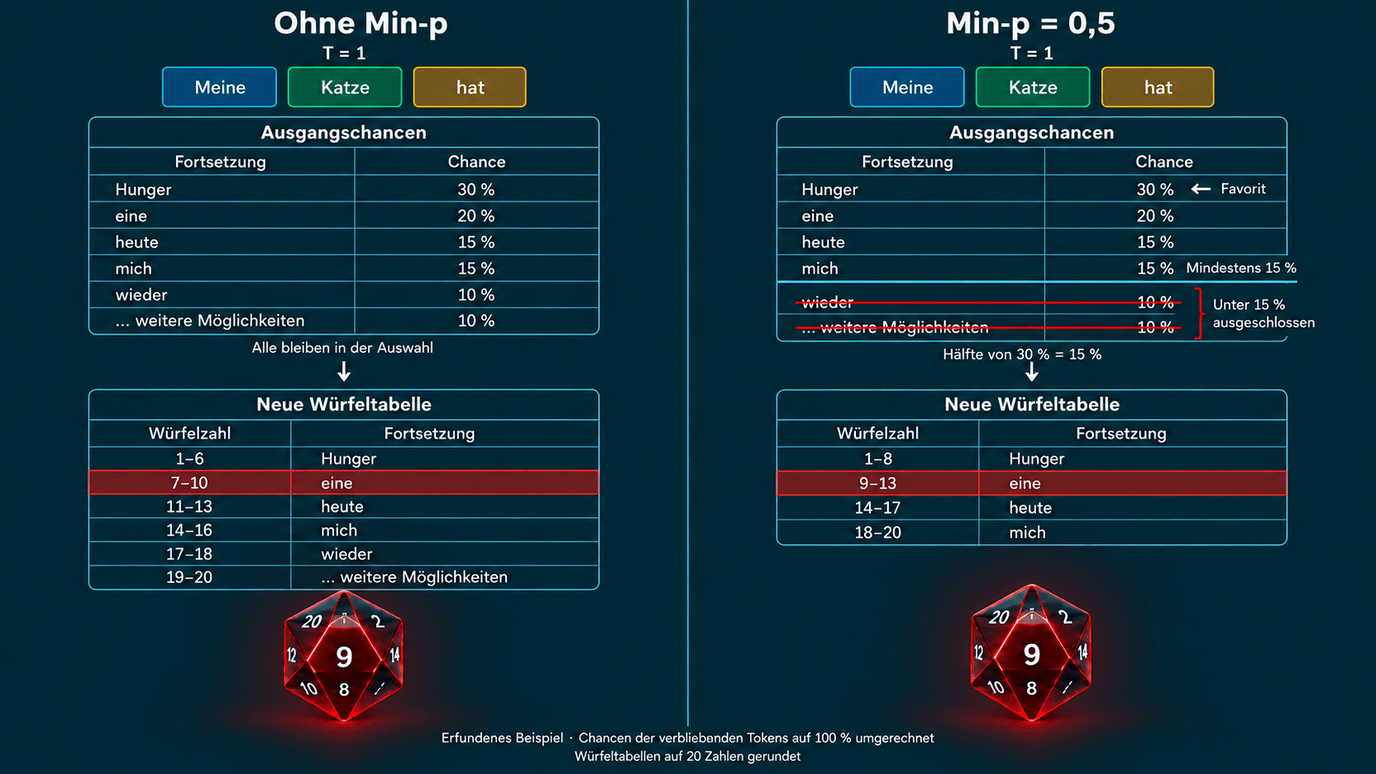
Min-p bestimmt, wie wahrscheinlich eine Fortsetzung im Vergleich zum Favoriten mindestens sein muss. Bei Min-p = 0,5 muss sie mindestens halb so wahrscheinlich sein. Hat „Hunger“ eine Chance von 30 Prozent, bleiben alle Fortsetzungen mit mindestens 15 Prozent übrig. [2]
Schwächere Kandidaten werden ausgeschlossen. Die verbleibenden Chancen werden wieder auf zusammen 100 Prozent umgerechnet. Anders als Top-k legt Min-p keine feste Anzahl fest. Seine Grenze richtet sich bei jedem Schritt nach der Wahrscheinlichkeit des aktuellen Favoriten.
Bildinhalt als Text
Beide Spalten beginnen mit „Meine Katze hat“ bei Temperature 1. Die erfundenen Ausgangschancen sind „Hunger“ 30 Prozent, „eine“ 20 Prozent, „heute“ 15 Prozent, „mich“ 15 Prozent, „wieder“ 10 Prozent und weitere Möglichkeiten zusammen 10 Prozent.
- Ohne Min-p bleiben alle Kandidaten. Die Bereiche sind 1 bis 6 für „Hunger“, 7 bis 10 für „eine“, 11 bis 13 für „heute“, 14 bis 16 für „mich“, 17 bis 18 für „wieder“ und 19 bis 20 für weitere Möglichkeiten.
- Bei Min-p 0,5 ist „Hunger“ mit 30 Prozent als Favorit markiert. Die Hälfte davon ergibt die Mindestchance von 15 Prozent. „Hunger“, „eine“, „heute“ und „mich“ bleiben. „Wieder“ und weitere Möglichkeiten liegen darunter und sind durchgestrichen.
- Die Chancen der verbliebenen Kandidaten werden auf 100 Prozent umgerechnet. Die gerundeten Bereiche sind 1 bis 8 für „Hunger“, 9 bis 13 für „eine“, 14 bis 17 für „heute“ und 18 bis 20 für „mich“.
Beide Würfel zeigen 9 und wählen „eine“. Min-p und Top-p lassen in diesem Beispiel dieselben Kandidaten übrig, setzen aber unterschiedliche Grenzen. Alle Werte sind erfunden und auf 20 Würfelzahlen gerundet.
Zwei Einstellungen, unterschiedliche Aufgaben
Temperature verändert, wie stark die wahrscheinlichsten Fortsetzungen bevorzugt werden. Top-p begrenzt, welche Fortsetzungen überhaupt an der Auswahl teilnehmen. Werden beide zusammen verwendet, wird zuerst die Gewichtung durch Temperature verändert. Anschließend zieht Top-p seine Grenze. [1] [3]
In unserem Würfelbild verändert Temperature also die Zahlenbereiche. Top-p streicht danach die Fortsetzungen außerhalb seiner Grenze und verteilt die Würfelzahlen auf die verbliebenen Möglichkeiten neu. Bei gleichem Top-p können deshalb je nach Temperature unterschiedlich viele Fortsetzungen übrig bleiben.
Universell beste Werte gibt es nicht. Welche Einstellung brauchbare Ergebnisse liefert, hängt vom Modell und der Aufgabe ab. Zum Ausprobieren hilft es, zunächst nur eine Einstellung zu verändern. So lässt sich leichter erkennen, was sie bewirkt. Welche Regler verfügbar sind und wie mehrere Filter kombiniert werden, hängt von der verwendeten Software ab.
Deeper into the Rabbit Hole
Videos auf Englisch
- 3Blue1Brown — Transformers, the tech behind LLMs — eine visuelle Vertiefung zu den Grundlagen der Tokenauswahl und Temperature. Für diesen Artikel wurde die entsprechende Textfassung gelesen.
- Gary Explains — The Secret Controls for your LLM: Temperature, Top-K, Top-P, etc — rund 15 Minuten über Temperature, Top-p und weitere Auswahlregler. Das Video wird von Genspark gesponsert. Titel und Beschreibung wurden geprüft, nicht das vollständige Video.
Texte
- 3Blue1Brown — Transformers, the tech behind LLMs — die bebilderte Textfassung erläutert, wie aus den berechneten Werten Auswahlwahrscheinlichkeiten werden und wie Temperature sie verändert.
- Holtzman et al. — The Curious Case of Neural Text Degeneration — die ursprüngliche Forschungsarbeit zu Top-p, auch Nucleus Sampling genannt. Abschnitt 3.1 erklärt die Auswahlgrenze mit Formeln. Die Ergebnisse stammen aus Versuchen mit damaligen Modellen und sind keine Qualitätsgarantie für heutige LLMs.
Quellen
- 3Blue1Brown — Transformers, the tech behind LLMs. Erklärung von Grant Sanderson, Textadaption von Justin Sun. Die Abschnitte zur Tokenauswahl, Softmax und Temperature wurden gelesen.
- vLLM — SamplingParams. Parameterbeschreibungen für Temperature, Top-p, Top-k und Min-p. Die Dokumentation beschreibt diese Software, nicht jede Anwendung.
- Holtzman et al. — The Curious Case of Neural Text Degeneration. ICLR 2020. Abstract und relevante Ausschnitte aus Abschnitt 3.1 und 3.2 gelesen, nicht die gesamte Arbeit.