
Wie wir in „Wie funktioniert ein LLM?“ gesehen haben, ist jede Anfrage an ein Sprachmodell zunächst ein abgeschlossener Vorgang. Warum wirkt ein Chat dann so, als würde sich die Maschine an unser Gespräch erinnern? Weil die Software bei einer neuen Anfrage auch bisherige Nachrichten mitgibt. Wie viel davon das Modell auf einmal verarbeiten kann, begrenzt das Kontextfenster. Seine Größe wird in Tokens angegeben. [1]
Die Größe des verfügbaren Kontextfensters hängt vom Modell und den Servereinstellungen ab. Manche Modelle können etwa 8.000 Tokens auf einmal verarbeiten, andere eine Million oder mehr. Der Server kann die nutzbare Größe zusätzlich begrenzen. Im Folgenden zeigen wir anhand von Bildern, wie ein Kontextfenster aufgebaut ist und sich während eines Gesprächs füllt. [1] [2]
1. Die erste Anfrage
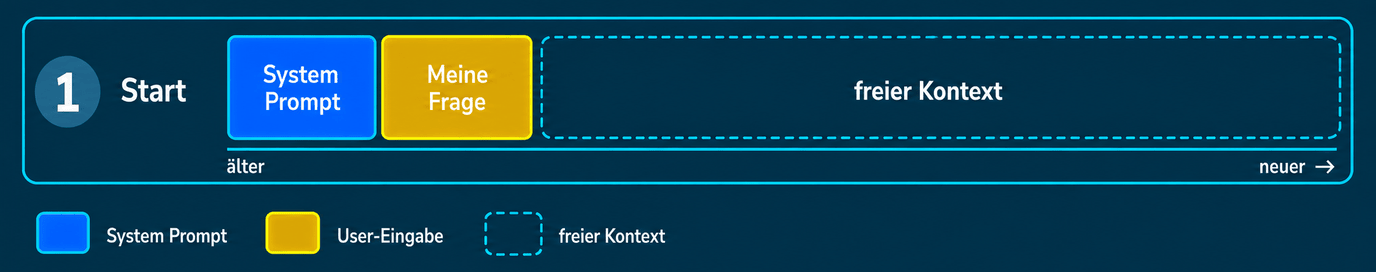
Am Anfang enthält der Kontext den Systemprompt mit den grundlegenden Anweisungen und deine erste Nachricht. Eine Antwort des LLM gibt es noch nicht. Auch diese erste Anfrage belegt also bereits einen Teil des Fensters. [1]
Bildinhalt als Text
Das Kontextfenster beginnt links mit dem blauen Systemprompt und der goldgelben ersten Anfrage. Eine Modellantwort ist noch nicht vorhanden. Der restliche Balken zeigt freien Kontext. Die zeitliche Reihenfolge läuft von links nach rechts. Die Breiten sind schematisch und keine realen Tokenmessungen.
2. Der Verlauf wächst
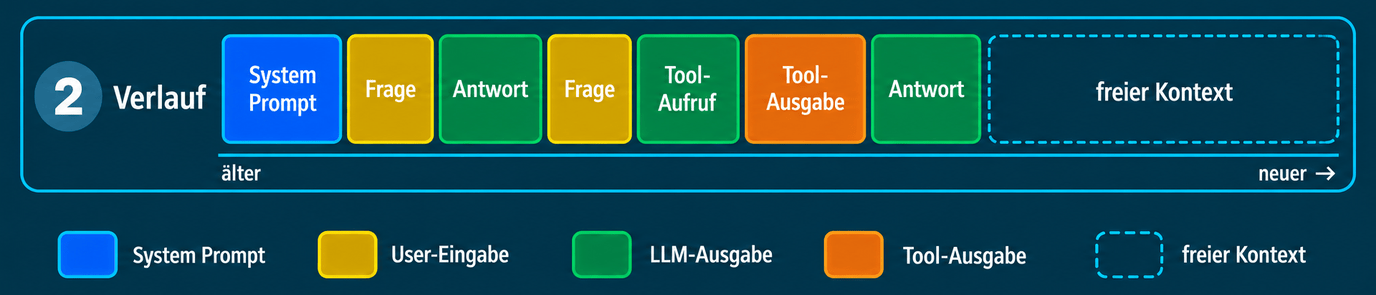
Mit der Antwort kommt weiterer Text hinzu. Bei der nächsten Anfrage gibt die Software den bisherigen Verlauf zusammen mit deiner neuen Nachricht mit. Nutzt das LLM Tools, kommen auch die Tool-Aufrufe und ihre Ausgaben dazu. So wächst der Kontext über mehrere Gesprächsrunden hinweg. Dieses erneute Mitgeben des Verlaufs ist kein dauerhaftes Gedächtnis des Modells. [1]
Bildinhalt als Text
Nach dem blauen Systemprompt folgen eine goldgelbe Anfrage und eine grüne Antwort. Eine zweite Anfrage führt zu einem grünen Tool-Aufruf des Modells, dann zu einer größeren orangefarbenen Tool-Ausgabe und schließlich zu einer grünen Antwort. Der Tool-Aufruf ist Modellausgabe, nicht Tool-Ausgabe. Freier Kontext bleibt rechts. Alle Breiten sind schematisch, keine Tokenmessungen.
3. Was davon ist noch relevant?
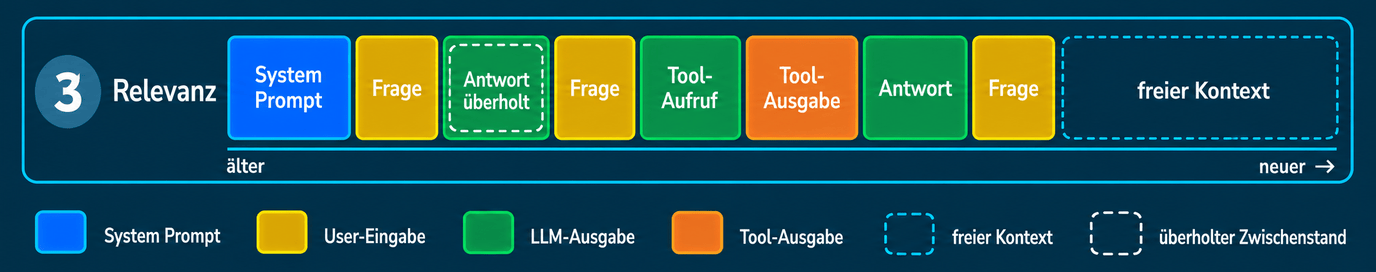
Im Verlauf bleiben auch verworfene Ansätze, überholte Zwischenstände und längst erledigte Rückfragen stehen. Sie belegen Platz neben den Informationen, die für die aktuelle Aufgabe wichtig sind. Bei langen oder widersprüchlichen Verläufen kann das LLM relevante Details übergehen oder vorhandene Anweisungen schlechter befolgen. Das passiert nicht zwangsläufig in jedem langen Chat und hängt nicht allein von der Zahl der Tokens ab. [3]
Bildinhalt als Text
Das Kontextfenster enthält weiterhin den blauen Systemprompt, zwei Gesprächsrunden mit einem Tool-Aufruf und einer größeren Tool-Ausgabe sowie eine weitere Anfrage. Die erste grüne Antwort ist mit einer weißen gestrichelten Innenkontur als überholter Zwischenstand markiert. Neuere Informationen können frühere Zwischenstände überholen. Die alten Inhalte bleiben vorhanden. Die Markierung steht weder für echtes Löschen noch für eine automatische allgemeine Drift. Die Breiten sind schematisch, keine Tokenmessungen.
4. Das Fenster wird voll
Der Kontext darf nicht den gesamten verfügbaren Platz beanspruchen, wenn noch eine Antwort entstehen soll. Auch deren Tokens brauchen Platz. Wie viel dafür vorgesehen ist und wie lang eine Antwort höchstens werden darf, hängt vom Modell und der Software ab. Die Chatsoftware oder das Harness kann außerdem schon vor der Modellgrenze ein eigenes Limit setzen. Was dann mit dem Verlauf geschieht, bestimmt die jeweilige Software. [1] [2]
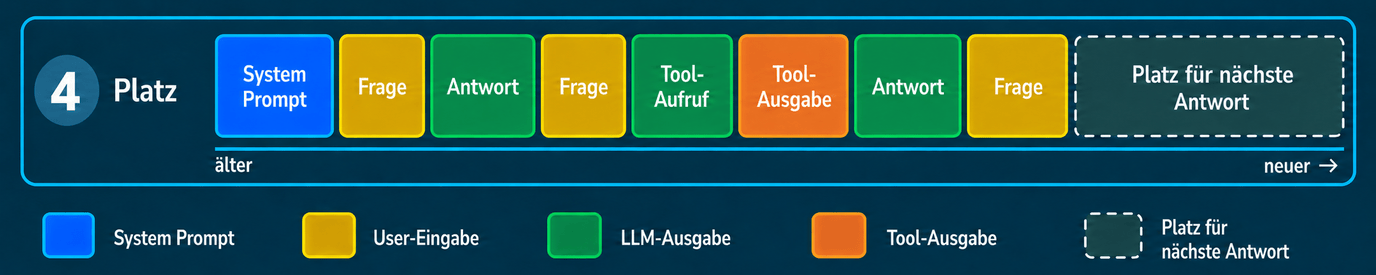
Bildinhalt als Text
Links stehen der blaue Systemprompt und der bisherige Gesprächsverlauf einschließlich der letzten Anfrage. Diese bereits vorhandenen Inhalte sind der Input. Rechts zeigt ein dezent getönter Block mit gestrichelter weißer Kontur Platz für die nächste, noch zu erzeugende Antwort. Dieser Block ist keine bereits vorhandene Modellausgabe und keine reale Größenprognose. Die schematische Darstellung zeigt, dass auch die Antwort in das begrenzte Kontextfenster passen muss. Es gibt keine festen Tokenwerte.
5. Die Dumb Zone
So nenne ich den Bereich, in dem der Kontext für meine Aufgabe bereits so verworren ist, dass die Antworten unschärfer oder unbrauchbar werden. Wo das beginnt, hängt von der Aufgabe, dem Inhalt und dem Server ab. Nach meiner Erfahrung ist dieser Bereich spätestens bei etwa 70 bis 80 Prozent des verfügbaren Kontextfensters erreicht. Bei größeren Kontextfenstern beobachte ich den Beginn oft schon bei 50 Prozent. Das sind Erfahrungswerte, keine festen technischen Grenzen. Bevor ich diese Grenze erreiche, möchte ich den Kontext verkleinern. Das geht zum Beispiel mit einer Compaction oder einem Session Handoff.
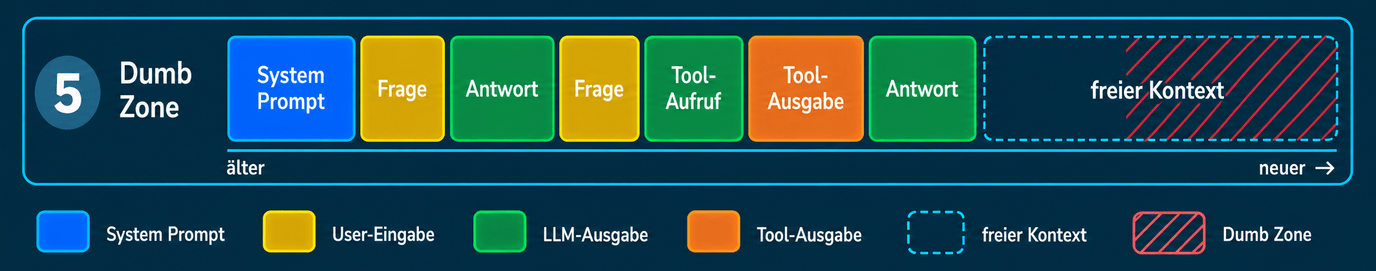
Bildinhalt als Text
Der blaue Systemprompt wird von zwei goldgelben Anfragen, grünen Antworten, einem grünen Tool-Aufruf und einer orangefarbenen Tool-Ausgabe gefolgt. Rechts bleibt freier Kontext. Eine rote Schraffur überlagert dessen rechten Bereich und markiert die Dumb Zone. Ihr schematischer Beginn ist eine persönliche Orientierung, keine universelle Schwelle und keine technische Grenze. Die tatsächliche Nutzbarkeit hängt unter anderem von Aufgabe und Kontextmix ab. Die Schraffur steht nicht für fest reservierten Speicher und behauptet keine automatische Verschlechterung. Breiten sind schematisch, keine realen Tokenmessungen.
6. Compaction
Bei einer Compaction fordert dein Harness oder deine Chatsoftware das LLM auf, die bisherige Session zusammenzufassen. Die Software ersetzt anschließend den alten Verlauf im Kontext durch diese Zusammenfassung. So entsteht wieder Platz, und das Gespräch wird mit dem verdichteten Kontext fortgesetzt. Manche Harnesses ermöglichen es, die Compaction mit eigenen Prompts zu steuern. Was vom bisherigen Arbeitsstand erhalten bleibt, hängt von der Qualität der Zusammenfassung ab. [3] [4]
Das Bild zeigt das Grundprinzip. Je nach Harness können neben der Zusammenfassung auch jüngere Nachrichten erhalten bleiben. [4]
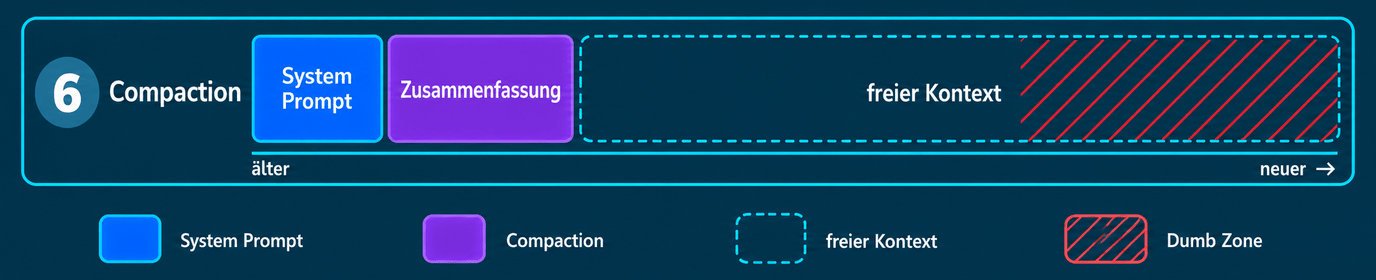
Bildinhalt als Text
Ein Kontextbalken zeigt dieselbe Session nach Compaction. Der blaue Systemprompt bleibt erhalten. Eine kompakte violette Zusammenfassung ersetzt den alten Gesprächsverlauf, sodass deutlich mehr freier Kontext entsteht. Es wird keine neue Session gestartet. Die rote Dumb-Zone-Schraffur bleibt im rechten Teil des freien Kontexts sichtbar. Ihr schematischer Beginn ist eine persönliche Orientierung, keine technische Grenze oder Speicherreservierung. Alle Breiten sind schematisch, keine Tokenmessungen.
7. Session Handoff
Bei einem Session Handoff erstellt das LLM eine Übergabe für eine neue Session. Darin stehen das aktuelle Ziel, der Arbeitsstand, wichtige Entscheidungen und die nächsten Schritte. Die neue Session beginnt mit dieser Übergabe statt mit dem bisherigen Gesprächsverlauf. Der Schwerpunkt liegt damit weniger darauf, das Gespräch zusammenzufassen, als darauf, die Arbeit fortsetzen zu können. Auch hier hängt das Ergebnis davon ab, welche Informationen übernommen werden und wie zuverlässig die Übergabe sie beschreibt. [5]
Ein praktisches Beispiel ist mein Projekt pi-blitz-handoff zum Organisieren von Handoffs zwischen Pi-Sessions. In der Sammlung Pi.dev-Toolbelt stelle ich es in einem eigenen Beitrag vor.
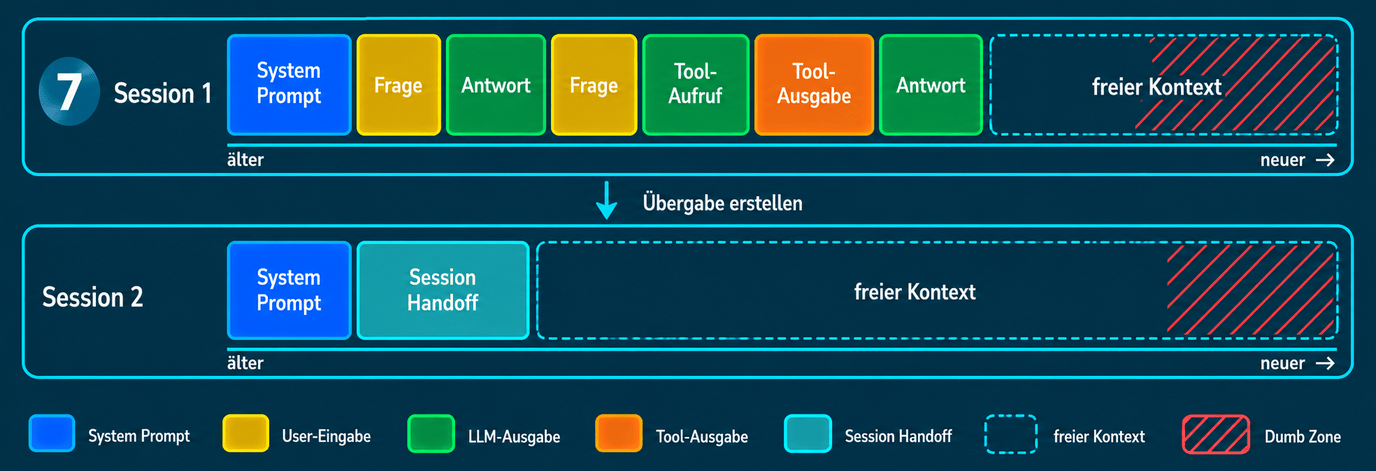
Bildinhalt als Text
Zwei gleich breite Kontextbalken zeigen zwei getrennte Sessions. Oben enthält Session 1 den blauen Systemprompt und den alten Verlauf mit Anfragen, Antworten, einem Tool-Aufruf und einer Tool-Ausgabe. Der Verbindungspfeil bezeichnet das Zusammenfassen zur Übergabe. Unten beginnt Session 2 ausschließlich mit einem blauen Systemprompt und einem gedeckt türkisfarbenen Session Handoff. Danach folgt freier Kontext. Es gibt unten weder eine neue User-Anfrage noch eine LLM-Antwort. Die Übergabe überträgt die zusammengefassten Informationen, nicht den gesamten alten Verlauf. Beide Balken tragen im rechten Teil des freien Kontexts die rote Dumb-Zone-Schraffur. Ihr schematischer Beginn variiert zwischen den Sessions. Diese persönliche Orientierung ist keine technische Grenze oder Speicherreservierung. Die Breiten sind schematisch, keine Tokenmessungen.
Compaction vs. Handoff — ein Flamewar
Aus diesen beiden Ansätzen muss kein Lagerstreit werden. Compaction verdichtet den Verlauf, um das laufende Gespräch fortzusetzen. Ein Handoff richtet den Kontext einer neuen Session auf die weitere Arbeit aus. Welcher Weg passt, hängt davon ab, was du erhalten möchtest und wie die Software damit umgeht. Beide können wichtige Details verlieren. Keiner ist für jede Aufgabe überlegen.
Deeper into the Rabbit Hole
Videos auf Englisch
- IBM Technology — What is a Context Window? Unlocking LLM Secrets — Martin Keen erklärt Tokens, Self-Attention und die Herausforderungen begrenzter Kontextfenster. Rund 12 Minuten.
- Matt Pocock — Most devs don’t understand how context windows work — Kontextgrenzen im Alltag mit Coding-Agenten, das „Lost in the Middle“-Problem und der Umgang mit langen Verläufen. Rund 10 Minuten, mit Beispielen zu Compaction und zusätzlichem Kontext durch MCP-Server.
- Marina Wyss — Context Engineering in 29 Minutes: Complete Course — ein längerer Überblick über Kontextstrategien für Agenten, typische Fehler und praktische Vorgehensweisen. Rund 29 Minuten. Das Video wird von Kimi gesponsert.
Texte
- Anthropic — Context windows — wie Nachrichten, Tool-Ergebnisse und erzeugte Antworten zum Fenster beitragen. Die Details beschreiben Claude, nicht jedes Modell.
- Anthropic — Effective context engineering for AI agents — Auswahl hilfreichen Kontexts, Compaction, externe Notizen und Subagents. Ein Praxisbeitrag eines Anbieters.
- Liu et al. — Lost in the Middle — eine Untersuchung zum Wiederfinden von Informationen in langen Eingaben. Der Abstract beschreibt den Einfluss ihrer Position. Daraus folgt keine allgemeine 70-Prozent-Grenze. [6]
Quellen
- Anthropic — Context windows.
- vLLM — Engine Arguments. Beispiel für die Serverkonfiguration.
- Anthropic — Effective context engineering for AI agents.
- Anthropic — Compaction overview.
- Mirco Blitz — pi-blitz-handoff — README v1.2.4. Veröffentlichter Produktstand v1.2.4.
- Liu et al. — Lost in the Middle: How Language Models Use Long Contexts. Abstract gelesen, der Volltext wurde für diesen Beitrag nicht ausgewertet.